Какой RAID выбрать на Dell PERC: RAID 5, 6 или 10 и что происходит при отказе диска?
RAID 5, RAID 6 и RAID 10 по-разному распределяют данные и защиту между дисками. Выбор уровня меняет полезную ёмкость, характер записи и условия сохранности массива при отказах. Для Dell PowerEdge этот выбор делают вместе с конкретным PERC, накопителями и планом восстановления.
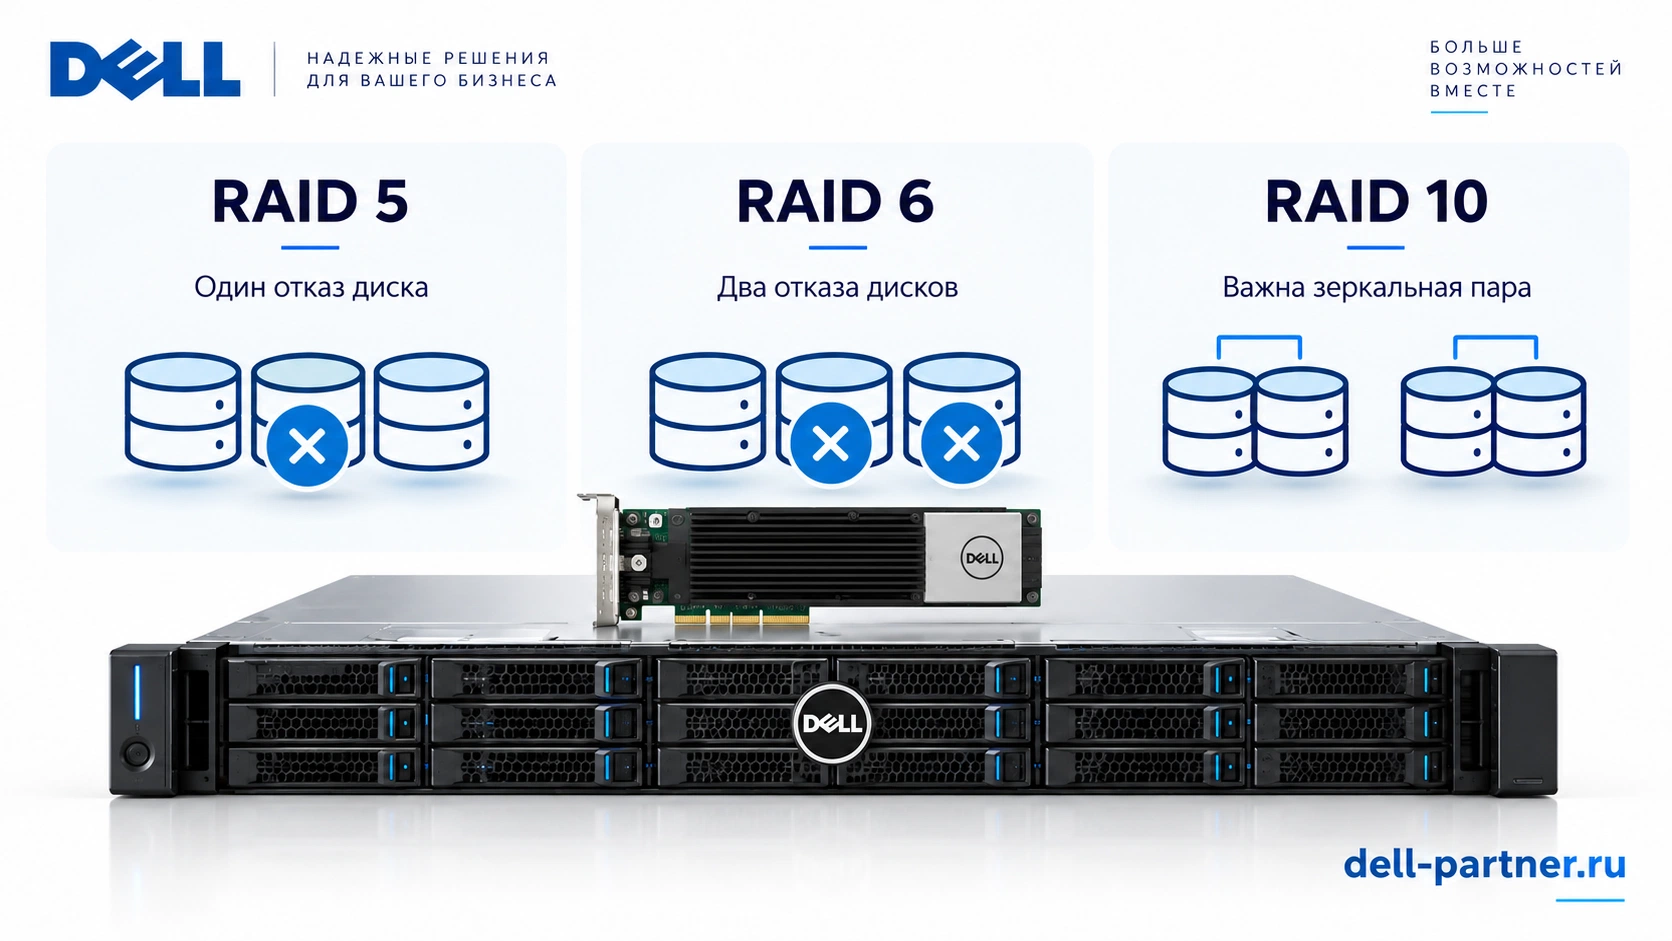
RAID 5 экономнее расходует ёмкость, RAID 6 выдерживает два отказа дисков в одном массиве, RAID 10 использует зеркальные пары и имеет другие условия отказа. Ни один уровень не является лучшим для всех нагрузок, и ни один не заменяет независимый backup.
Ниже — расчёты на одинаковом наборе дисков, сравнение записи и rebuild, роль кеша PERC и вопросы приёмки. Это руководство по логике массива. Подробный подбор интерфейса и ресурса накопителя разбирается в статье о совместимом SSD для Dell PowerEdge.
Что делает RAID и от чего он не защищает?
RAID объединяет накопители и, для уровней с избыточностью, позволяет работать при определённых отказах. Он не создаёт отдельную историю документов и не восстанавливает автоматически удалённый пользователем файл.
Ошибка приложения, ransomware, повреждение файловой системы, пожар и потеря всего сервера выходят за простую защиту от отказа диска. Backup проектируют отдельно с проверяемым восстановлением и независимым доступом к копии.
Также RAID не гарантирует отсутствие простоя. После отказа меняются производительность и запас защиты. Если диск заменяют несколько дней, массив долго остаётся в уязвимом состоянии.
В проекте нужны два решения: допустимый набор отказов и способ восстановления данных при потере системы. Покупка контроллера с большим номером не отвечает на второй вопрос.
RAID 5, 6 и 10: как устроена защита?
RAID 5 использует распределённую чётность с расходом ёмкости, эквивалентным одному диску. Чётность не находится постоянно на одном «специальном» диске. При отказе одного накопителя недостающие данные восстанавливаются из остальных.
RAID 6 использует двойную распределённую чётность и выдерживает отказ любых двух дисков в одном таком массиве. Расход ёмкости эквивалентен двум дискам, однако стоимость защиты не сводится только к терабайтам.
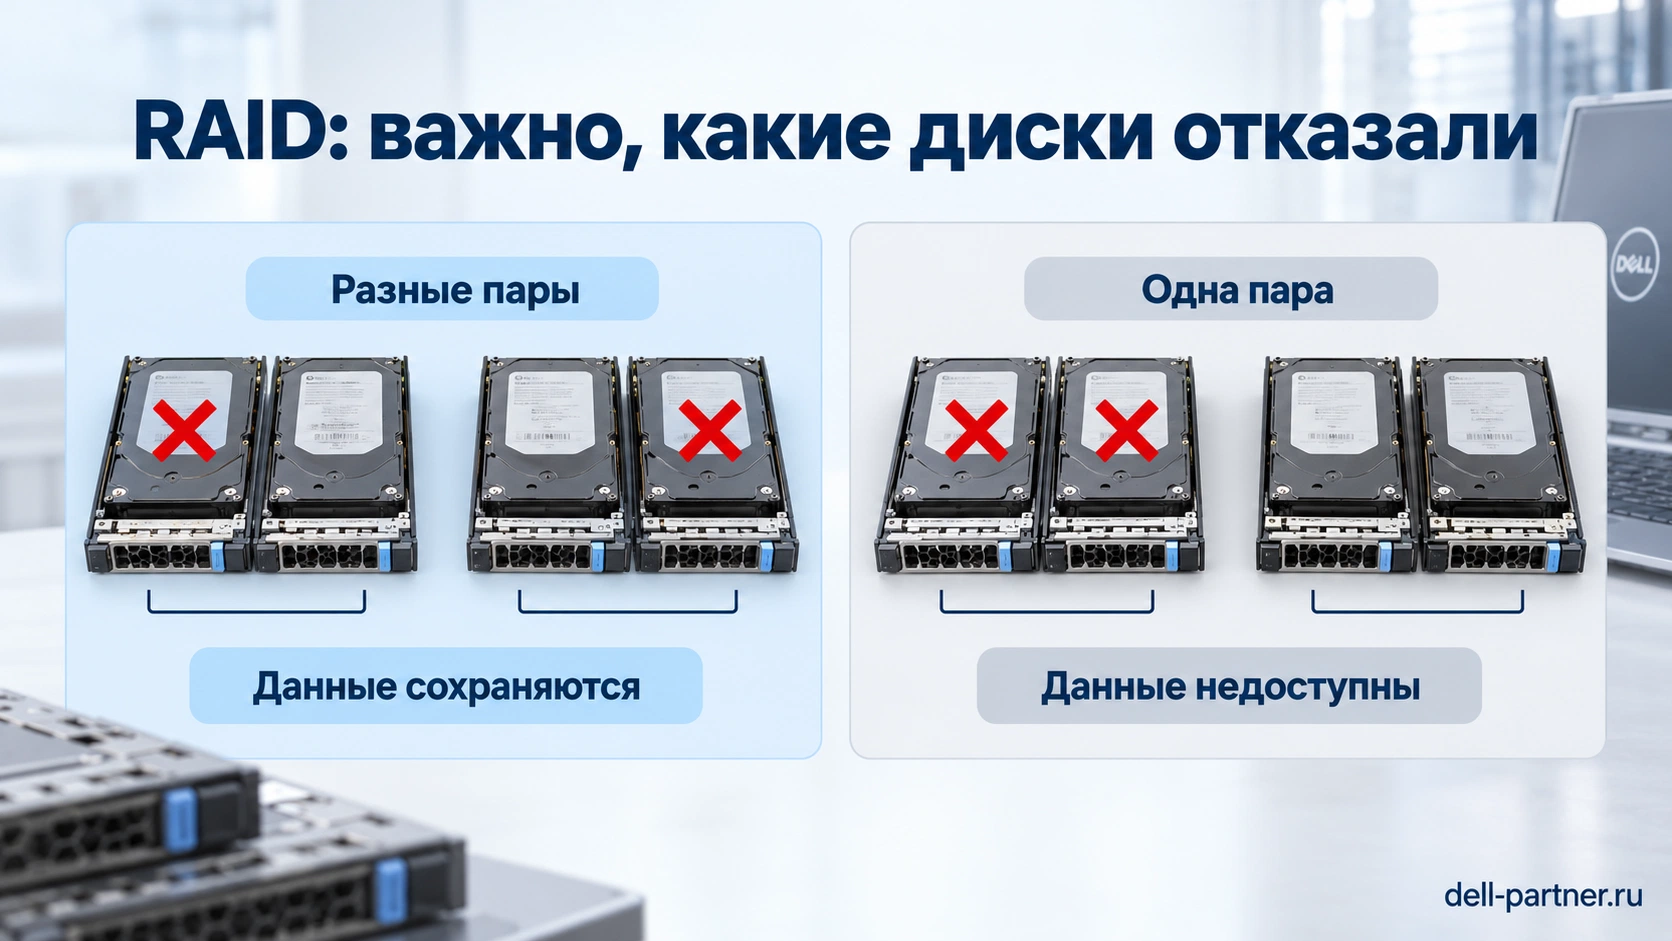
RAID 10 в обычной схеме объединяет зеркальные пары с распределением данных между ними. Один отказ в паре допустим, потеря обоих её дисков приводит к потере массива. Поэтому правило «можно потерять половину дисков» без указания расположения неверно.
Количество накопителей и поддерживаемые варианты проверяют по конкретному PERC. Для обычной схемы из нескольких зеркал RAID 10 используют чётное число дисков от четырёх; отдельные реализации могут допускать иной минимальный состав.
| Уровень | Защита | Условие |
|---|---|---|
| RAID 5 | Один отказ | Второй отказ до восстановления опасен |
| RAID 6 | Любые два отказа | Третий выходит за защиту уровня |
| RAID 10 | Один диск в каждой сохранившейся паре | Нельзя потерять оба диска одной пары |
| RAID 0 | Нет избыточности | Отказ диска приводит к потере массива |
Условия RAID 10 нужно читать по структуре конкретного массива. Для обычных зеркальных пар одновременная потеря обоих участников одной пары приводит к потере доступности данных массива. Допустимое число разных отказов нельзя описывать одной фразой «выдержит половину дисков» без карты расположения.
Как посчитать ёмкость: пример восьми дисков по 4 ТБ
Для одинаковых дисков по S и количества N учебные формулы полезной ёмкости до системных расходов такие: RAID 5 — (N − 1) × S, RAID 6 — (N − 2) × S, RAID 10 — N × S / 2 в обычной схеме зеркал.
При восьми накопителях по 4 ТБ получаем 32 ТБ raw, 28 ТБ для RAID 5, 24 ТБ для RAID 6 и 16 ТБ для RAID 10. Это ещё не место, которое следует полностью заполнять файлами.
Дальше учитывают форматирование, файловую систему, служебные расходы, рабочий резерв и приложения. TB и TiB различаются: 16 десятичных TB — примерно 14,55 TiB до следующих расходов.
Hot spare в эти восемь активных дисков примера не включён. Если один из восьми отсеков занимает spare, расчёт проводят по семи активным дискам и проверяют допустимость состава выбранного уровня. Для RAID 10 число активных дисков должно соответствовать поддерживаемой схеме.
| Показатель | RAID 5 | RAID 6 | RAID 10 |
|---|---|---|---|
| Raw | 32 ТБ | 32 ТБ | 32 ТБ |
| Расчёт до расходов файловой системы | 28 ТБ | 24 ТБ | 16 ТБ |
| Доля raw | 87,5% | 75% | 50% |
| Защита | Один диск | Два диска | По зеркальным парам |
| Рабочее свободное место | Рассчитать отдельно | Рассчитать отдельно | Рассчитать отдельно |
RAID 5 или RAID 10: что лучше при частой записи?
Для небольшой случайной записи parity-массив выполняет дополнительные операции. В упрощённой модели read-modify-write RAID 5 требует примерно четырёх физических I/O, RAID 6 — шести, зеркальная запись — двух. Это объясняющая модель, не прогноз IOPS конкретного PERC.
Полная запись stripe, кеш, объединение операций, SSD и нагрузка меняют результат. Нельзя умножить паспортную скорость диска на число накопителей и поделить на penalty, получив гарантию базы данных.
RAID 10 часто рассматривают для чувствительной к задержке смешанной или транзакционной нагрузки. Цена — расход половины ёмкости. RAID 5/6 могут быть рациональны для иных профилей и достаточного измеренного результата.
При сравнении тестируйте одинаковые накопители, рабочий объём, политику кеша и состояние защиты. Последовательное чтение пустого массива не отвечает на вопрос о случайной записи заполненной системы.
Когда RAID 6 разумнее RAID 5?
RAID 6 даёт дополнительную защиту в период rebuild. Это особенно важно, когда восстановление длительное, массив большой, а быстрая замена и низкая нагрузка не гарантированы.
Но выбирать уровень только по ёмкости дисков неправильно. Важны число участников, фактическая скорость восстановления, здоровье остальных дисков, допустимый риск и независимые копии.
RAID 5 не следует объявлять запрещённым для всех проектов. Его пригодность определяется поддержкой, нагрузкой и согласованными условиями. Однако решение «больше usable за ту же цену» должно учитывать последствия второго отказа.
При RAID 6 после первого отказа остаётся защита ещё от одного диска, но это не повод откладывать замену. Сниженная избыточность и ухудшившаяся производительность требуют контроля и восстановления штатного состояния.
| Профиль | Что сравнить | Возможный компромисс |
|---|---|---|
| Частая мелкая запись | Latency и rebuild | RAID 10 ценой ёмкости |
| Большая ёмкость и длительный rebuild | Запас защиты | RAID 6 ценой usable и записи |
| Умеренная нагрузка | Фактический результат и риск | RAID 5 при согласованных условиях |
| Временные данные | Возможность полного повторного создания | RAID 0 только без ожидания защиты |
Сколько времени занимает rebuild?
Rebuild читает доступные данные и восстанавливает избыточность на заменённом диске. Скорость зависит от уровня, дисков, контроллера, настроек, очередей и нагрузки приложения. Одна универсальная длительность отсутствует.
Учебный нижний ориентир: 4 ТБ при устойчивых 100 МБ/с требуют 40 000 секунд, то есть примерно 11,1 часа. Реальное восстановление включает другие операции и может длиться больше. Этот расчёт не является прогнозом конкретного массива.
Высокий приоритет rebuild способен ухудшить работу приложения. Низкий — продлить период сниженной защиты. Выбор делают по сервисным требованиям, а не всегда выставляют максимум.
При приёмке полезно измерить работу приложения в degraded и rebuild-режимах. Тест проводят на согласованном стенде или в сервисном окне, сохранив backup. Не извлекайте рабочий диск для эксперимента без процедуры.
Rebuild не равен простой передаче полезных данных одним кабелем. Контроллер читает сохранившиеся компоненты, восстанавливает содержимое и обслуживает рабочие операции. Приоритет влияет на время и задержку приложений. Поэтому формула объём/скорость даёт ориентир масштаба, а реальные сроки проверяют на поддерживаемом наборе и нагрузке.
Как RAID 10 переносит два отказа?
Рассмотрим четыре зеркальные пары: A1/A2, B1/B2, C1/C2, D1/D2. Отказы A1 и B1 оставляют по одному доступному диску в соответствующих парах. Отказы A1 и A2 уничтожают одну пару и выходят за защиту массива.
Таким образом, число отказов само по себе недостаточно. Нужна карта зеркал и понимание расположения дисков. Вывод «RAID 10 надёжнее RAID 6 при любых двух отказах» неверен.
Поведение rebuild у зеркала отличается от parity, но не отменяет необходимости проверки оставшегося диска пары. Ошибки чтения и состояние накопителей влияют на результат восстановления.
Для эксплуатации сохраняйте карту физических слотов и виртуальных дисков. Уведомление должно помогать найти именно отказавший накопитель. Замена исправного диска по непроверенному номеру слота может ухудшить ситуацию.
Нужен ли hot spare и сколько места он забирает?
Hot spare — совместимый резервный диск для автоматического восстановления при поддерживаемой политике. Он уменьшает время ожидания физической замены, но сам не добавляет новый уровень защиты RAID.
Spare должен иметь подходящие интерфейс, формат и достаточную ёмкость. Для нескольких массивов проверьте global/dedicated-политику и возможность использования конкретного резерва.
Если spare занимает отсек, этот отсек уже нельзя одновременно считать активной ёмкостью. Для RAID 10 особенно важно сохранить допустимое чётное число активных участников.
После автоматического восстановления резерв нужно вернуть в штатное состояние по выбранной процедуре. Мониторинг обязан сообщать не только отказ, но и завершение rebuild и отсутствие доступного spare.
Write-back, write-through и защита кеша PERC
Write-back подтверждает запись после её попадания в кеш контроллера при предусмотренной защите. Write-through подтверждает после передачи дальше по пути записи. Производительность может существенно различаться.
Если защита кеша неисправна, контроллер способен переходить на другую политику. Внезапное замедление записи поэтому не всегда означает износ всех SSD. Проверяют состояние PERC, защитного модуля, firmware и событий.
Принудительный write-back без требуемой защиты не является безопасным универсальным ускорением. UPS также не заменяет все механизмы сохранения кеша при отказе компонентов.
Кеш самого накопителя — отдельный уровень. Power-loss protection диска, политика PERC и подтверждение записи приложению должны образовывать согласованную цепочку. Не переносите настройку одного контроллера на любое поколение.
| Узел | Возможная причина | Проверка |
|---|---|---|
| PERC | Изменение cache политики | Политика и события |
| Защита кеша | Неисправность модуля | Состояние и поддерживаемая замена |
| Диски | Ошибки, ресурс, разные модели | Health и совместимость |
| Массив | Rebuild или background task | Текущее состояние и приоритет |
| Приложение | Другой профиль операций | Latency, размер блока, очередь |
Защита кеша проверяется как часть состояния контроллера. Источник бесперебойного питания помогает всей системе, но не заменяет каждый механизм сохранения ещё не записанных данных. Выбор политики кеширования без проверки предусмотренной защиты способен изменить риск потери подтверждённых записей.
Любой ли PERC управляет SAS, SATA и NVMe?
Нет. Поддержка зависит от модели контроллера, платформы, backplane и кабельного комплекта. NVMe может подключаться иначе, чем SAS/SATA. Название PERC не гарантирует аппаратный RAID для любого NVMe.
Накопители проверяют по интерфейсу, формату секторов, carrier и firmware. Одинаковые 2,5 дюйма не означают одинаковый электрический и программный путь.
При использовании ZFS, Ceph или другого ПО-defined storage требования к доступу к дискам отличаются от обычного оборудование RAID. Не накладывайте массив PERC автоматически под любой программный стек.
Подбирайте контроллер Dell вместе с платформой и дисками. До заказа должны быть определены режим и способ видимости накопителей в целевой ОС.
Пример: одинаковые диски и разные требования приложения
В условном заказе восемь активных дисков по 4 ТБ и отдельный spare. Приложению нужно 12 ТБ сегодня и ещё 3 ТБ в течение проекта. Обычный RAID 10 даёт 16 ТБ до расходов файловой системы; бюджет 15 ТБ оставляет слишком мало места для расходов и рабочих операций.
Это не делает RAID 10 неправильным уровнем. Выбранного состава может быть недостаточно при такой политике роста. Пересчитайте диски, ёмкость или бюджет, сохранив требуемый профиль записи.
RAID 6 даёт 24 ТБ до следующих расходов, но его задержку при целевой записи проверяют. Если приложение не проходит приёмку, дополнительные терабайты не компенсируют нарушение рабочего требования.
RAID 5 даёт ещё четыре терабайта относительно RAID 6. Цена выигрыша — другой запас отказов. Сравнение учитывает rebuild и скорость реакции; универсальные проценты надёжности придумывать нельзя.
Spare сокращает ожидание начала восстановления, но не заменяет мониторинг. После его использования нужно вернуть резерв. Иначе следующий отказ может остаться без автоматического начала rebuild.
Приёмка включает производительность на заданном объёме и отдельное восстановление из backup после условной потери системы. Первый тест подтверждает массив, второй — возможность вернуть бизнес-сервис.
Архив, база и временный вычислительный набор могут требовать разных уровней. Не унифицируйте все данные одним RAID ради простого заказа. Сохраняйте назначение каждого virtual disk и обслуживаемые условия отказа.
Как сравнить полезную ёмкость RAID и свободный резерв приложения?
Формула уровня RAID даёт ёмкость массива до части последующих расходов. Затем учитывают файловую систему, служебные данные и свободное место приложения. Запасной диск не становится активной полезной ёмкостью, если он выделен как hot spare. Эти уровни бюджета нужно показывать отдельно.
Для восьми одинаковых активных дисков по 4 ТБ обычные формулы дают 28 ТБ для RAID 5,24 ТБ для RAID 6 и 16 ТБ для RAID 10 из зеркальных пар. Если один из восьми должен быть отдельным spare, активных дисков становится меньше, и прежние значения уже неприменимы. Для RAID 10 также нужно сохранить допустимое число и структуру участников.
Пусть приложению требуется 12 ТБ сегодня и 15 ТБ на горизонте проекта. При политике 20% свободного места целевой полезный ресурс —18,75 ТБ до иных расходов. RAID 10 на восьми 4 ТБ даёт 16 ТБ до файловой системы и не покрывает это условие. Это не доказательство, что уровень плох: недостаточен выбранный состав для данного требования.
RAID 6 даёт другой ресурс ёмкости, но его рабочую запись и аварийное состояние нужно испытать. Если приложение не проходит по задержке, дополнительные терабайты не компенсируют нарушенный сервис. Можно изменить состав дисков, архитектуру или распределение задач, сохраняя исходное требование.
Полный бюджет также включает план роста и замены. Увеличение virtual disk зависит от поддержки контроллера и схемы; не любой переход выполняется без ограничений и простоя. Возможность будущего расширения проверяют до покупки, а важные данные сохраняют в независимой проверенной копии.
| Уровень | Ёмкость до дополнительных расходов | Защита в обычной схеме |
|---|---|---|
| RAID 5 | 28 ТБ | Один отказ диска |
| RAID 6 | 24 ТБ | Любые два отказа в массиве |
| RAID 10 | 16 ТБ | По одному отказу в каждой сохранившейся зеркальной паре |
| Для всех строк | Spare, файловую систему и свободный запас отдельно | Независимый backup отдельно |
Почему два отказа в RAID 10 дают разные результаты?
Рассмотрим обычный RAID 10 из четырёх зеркальных пар, всего восемь дисков. Если отказывает по одному диску в двух разных парах, в каждой остаётся копия. Если оба отказа попадают в одну пару, эта часть данных теряется и массив не обеспечивает прежний доступ. Число отказов одинаковое, структура разная.
Можно посчитать комбинации: для двух разных отказавших дисков из восьми имеется 28 неупорядоченных пар. Четыре комбинации соответствуют целиком потерянным зеркальным парам. Это комбинаторика описанной схемы, а не прогноз вероятности аварии оборудования. Реальные отказы не обязаны быть независимыми или равновероятными.
Общие питание, температура, партия дисков, кабель и контроллер способны делать события связанными. Поэтому нельзя превратить 4 из 28 в годовую вероятность потери данных или процент надёжности Dell. Такой прогноз потребовал бы другую модель и достоверные данные. Учебный счёт помогает только понять условие защиты.
Сохраните карту участников и принадлежность к зеркалам. При сервисной работе важно не извлечь второй нужный диск ошибочно. Цвет индикатора и правильный отсек должны быть связаны с журналом и подтверждённой процедурой, а не с догадкой по внешнему виду. Для аварийного обслуживания нужен ответственный инженер.
Также проверяют возврат резерва после rebuild. Пока неисправный участник не заменён, массив находится в другом защищённом состоянии. Возможность пережить конкретный следующий отказ зависит от оставшихся компонентов. Успешный доступ сегодня не означает, что исходная защита уже восстановилась.
Что значит write penalty и почему она не даёт готовые IOPS?
Упрощённая модель небольшой случайной записи с read-modify-write добавляет операции чтения и записи данных/чётности. Часто приводят условные штрафы 4 для RAID 5,6 для RAID 6 и 2 для зеркала. Эти числа объясняют механизм, но не являются точной характеристикой каждого контроллера, диска и профиля.
Кеш, объединение записей, полные полосы, размер блока и очередь меняют физическую работу. Поэтому делить паспортные IOPS накопителей на 4 или 6 и обещать конечный результат приложения неточно. Тест должен воспроизводить рабочий набор и долю чтения/записи в выбранной конфигурации.
Для приложения чувствительна задержка подтверждения записи. Работа через защищённый write-back может отличаться от write-through. Но высокий короткий результат в кеше не показывает длительную устойчивую запись после его заполнения. В протоколе фиксируют политику кеша, защиту и продолжительность теста.
При отказе диска профиль меняется: часть операций выполняется иначе, а rebuild добавляет нагрузку. Если приложение должно работать в этот период, испытание штатного массива недостаточно. Нужно проверить согласованный аварийный сценарий и приемлемое время ответа.
Выбор RAID 10 ради записи оправдывают реальным требованием и бюджетом ёмкости. Выбор RAID 6 ради двойной чётности также требует проверки приложения. Нет универсального уровня, который одновременно максимизирует полезное место, скорость любой операции и защиту от всех событий.
Hot spare, rebuild и мониторинг: как сократить незащищённый период?
Spare позволяет начать предусмотренное восстановление без ожидания физической замены отказавшего диска, если выполнены условия поддерживаемого состава и назначения. Но он не ускоряет любую операцию автоматически и не возвращает систему к исходному запасу сам по себе. После использования требуется восстановить резерв.
Проверяют ёмкость, интерфейс, поддерживаемый тип и область применения spare. Глобальное и выделенное назначение могут обслуживать разные массивы. Важно понимать, какой отказ вызывает его использование и какие группы остаются без резерва. Один запасной диск не гарантирует восстановление нескольких одновременных событий.
Время rebuild зависит от объёма, дисков, нагрузки, политики и состояния оставшихся компонентов. Учебная передача 4 ТБ со скоростью 100 МБ/с занимает около 11,1 часа, но фактическая работа сложнее и может длиться дольше. Цифру нельзя превратить в гарантированный срок любого PERC.
Уведомления должны приходить ответственному и содержать следующий шаг. Отдельно отслеживают обнаружение отказа, начало rebuild, его ошибки, завершение и возврат spare. Если мониторинг ограничен общей зелёной отметкой сервера, переход в деградированный режим может остаться без своевременного обслуживания.
Для сервисного окна согласуйте влияние на приложение. Максимальный приоритет rebuild способен менять рабочую задержку, меньший — увеличивать период восстановления. Выбор связан с требованием бизнеса и оценкой риска. Предусмотренная независимая копия остаётся нужна независимо от выбранной политики.
Как принять массив PERC и не потерять данные при изменении конфигурации?
Сначала сверяют контроллер, диски, backplane, кабели, прошивки, virtual disks и политики. PERC разных поколений имеет разную поддержку; слово NVMe не означает управление любой NVMe-платой каждым контроллером. Подбирают полный поддерживаемый путь, а подробные артикулы SSD рассматривают в отдельной статье.
Для нового массива проверяют обнаружение, правильную ёмкость, состояние защиты и рабочий тест. При изменении существующего проекта особенно важно сохранить актуальную резервную копию и предусмотренный способ восстановления. Доступная операция управления не является гарантией отсутствия ошибки пользователя или неисправности во время изменения.
Не выполняйте разрушительные нагрузочные тесты на рабочем томе ради сравнительной цифры. Для приёмки выделяют согласованную область и способ, который соответствует проекту. Протокол должен описывать, какие данные использовались и какие операции были безопасно испытаны.
В аварийной части проверяют оповещение, деградированную работу и восстановление при предусмотренном сервисном сценарии. Случайное извлечение дисков без карты и процедуры не является корректной проверкой RAID. Операции должны быть контролируемыми и не создавать потерю бизнес-данных.
Последний тест — независимое восстановление приложения или нужного набора из backup. RAID помогает доступности при конкретных отказах дисков, но не исправляет удалённые файлы, повреждение приложения или потерю всей площадки. Закупка завершена, когда подтверждены и массив, и согласованный путь возврата данных.
RAID 5 на больших дисках: как принять решение без универсального запрета?
Сравнивайте допустимое число отказов, размер массива, время восстановления и требования приложения. Сам размер диска не превращает уровень в автоматически запрещённый или подходящий для всех данных. Но он влияет на объём восстановления и условия аварийного периода.
RAID 5 оставляет другой запас отказов, чем RAID 6. Если бизнес требует перенести любые два отказа в пределах выбранного массива, обычный RAID 5 не выполняет условие. Это прямое различие защиты, не оценка конкретной вероятности поломки. Требование не следует менять незаметно ради ёмкости.
Оцените мониторинг и скорость сервиса. Длительное обнаружение отказа увеличивает период изменённого состояния ещё до rebuild. Запасной диск и ответственный инженер помогают разным этапам; они не делают уровень защиты одинаковым с другим RAID.
Для временных данных, восстановимых из другого источника, допустимый сценарий может быть иной, чем для критичной базы. Не унифицируйте уровни только ради простого заказа. У каждой области должна быть связь с сервисным требованием и независимым восстановлением.
Сохраните аргументы в спецификации: почему выбран уровень, какая ёмкость нужна, что выдерживается и как возвращается защита. Такой выбор можно проверить через год. Общая фраза «этот RAID самый надёжный» не описывает ограничения.
RAID 10 или RAID 6 для записи: как проверить реальный профиль?
Сначала задайте размер блока, долю записи, параллельность, рабочий набор и допустимую задержку. Если приложение выполняет много коротких зависимых записей, максимальное последовательное чтение не является нужным тестом. Для другого процесса профиль может быть обратным.
На одинаковых дисках и контроллере сравнивают нормальное состояние, длительность и доступную полезную ёмкость. Политика кеша и её защита должны совпадать или быть явно указаны. Иначе часть разницы создаёт настройка, а не уровень RAID.
Не выбирайте результат по первым секундам. Кеш способен дать высокий короткий поток, который меняется при длительной работе. Для задачи с часовой загрузкой нужен соответствующий прогон. Сохраняйте ошибки и задержку вместе с IOPS.
Затем проверяют согласованный деградированный режим и восстановление. Скорость исправного массива может быть достаточной, но приложение должно сохранять требование в период rebuild, если так задано. Дополнительная ёмкость не заменяет нарушенное время ответа.
Итогом является выбор поддерживаемого состава и уровня под один и тот же сервис. RAID 10 может быть рационален ценой места, RAID 6 — при другом балансе и подтверждённой нагрузке. Универсальное ранжирование без профиля не даёт полезного решения.
Можно ли расширить массив или заменить диски без нового проекта?
Возможности изменения зависят от контроллера, уровня, дисков, версии и текущей конфигурации. Наличие операции в одном PERC не означает поддержку любого другого. До покупки проверяют следующий допустимый шаг, необходимое время и условия сохранения данных.
Замена дисков на более крупные не обязана мгновенно увеличить видимую ёмкость virtual disk. В проекте есть порядок замены, восстановления и последующего изменения, если это поддержано. После каждого этапа сохраняется определённое состояние защиты. Эти действия не следует выполнять по общему совету из другой модели.
Важные данные заранее имеют независимую проверенную копию и путь возврата. Программно поддерживаемая операция не исключает неисправность или ошибку в момент изменения. Если допустимо другое окно, иногда понятнее перенос на новый готовый массив, чем сложная перестройка старого.
Оцените нагрузку и свободное пространство во время перехода. Изменение может выполнять дополнительные операции и длиться больше, чем короткая демонстрация. Для критичного приложения нужен согласованный режим, а не надежда сохранить прежнюю скорость при любых работах.
После завершения сверяют полезную ёмкость, состав, ошибки, резерв и backup. Обновляют карту участников и дальнейшее расширение. Поставщик должен показать не только возможность начала операции, но и подтверждаемый конечный результат.
Что делать при ошибке контроллера или потере всего сервера?
RAID уровень описывает предусмотренные отказы дисков, но не весь комплект. Контроллер, кабели, backplane, питание и сам сервер могут стать отдельными событиями. Поэтому карта защиты не должна заканчиваться числом дисков чётности.
Для замены контроллера требуется поддерживаемая процедура с сохранением конфигурации и данных. Не следует случайно инициализировать обнаруженный массив только потому, что новая система предлагает такую кнопку. Работы выполняют по сервисному пути и согласованному плану.
Полная потеря платформы может потребовать восстановления на другом ресурсе. Наличие дисков с RAID не гарантирует срок, если нет подходящего оборудования, прав и доступа. Независимая копия сохраняет свой смысл и при высоком уровне защиты массива.
В приёмке отдельно проверяют возврат приложения или важных данных из backup. Это другой результат, чем перестроение после одного диска. Оба сценария должны соответствовать задаче, если они обязательны.
Сохраните конфигурацию, версии, журналы и ответственных. Это уменьшает неопределённость аварийной работы и помогает отличить поддерживаемую замену от опасного эксперимента. Задача состоит в возврате данных, а не в быстром выполнении случайных операций контроллера.
Чек-лист окончательного выбора Dell PERC и уровня RAID
Укажите полезный бюджет, профиль чтения/записи, время ответа, согласованные отказы и срок возврата защиты. Только после этого сравнивают уровни и состав дисков. Физические терабайты являются исходной частью, а не готовым ресурсом приложения.
В аппаратной части нужны контроллер, поддерживаемые накопители, дисковая плата, кабели, прошивка и политики кеша. Условия допущения аналога формулируют полностью. Один совместимый артикул диска не подтверждает весь массив.
Spare и мониторинг записывают отдельно. Кто увидит отказ, когда начнётся восстановление и как вернётся запас? Ответы описывают операционный период, который формулой ёмкости не определяется.
Для приёмки покажите данные, методы, длительность, аварийный режим и восстановление из копии. Не используйте общую обещанную цифру IOPS вместо контроля приложения. Состав, на котором прошёл тест, должен соответствовать поставке.
После изменения нагрузки или роста данных пересмотрите расчёт. Старый выбор уровня может оставаться подходящим, но может потребовать новых дисков или иной архитектуры. Решение должно сохранять явную связь с сервисом и независимой защитой данных.
Как проверить массив и подготовить заказ?
Сначала фиксируют нагрузку: последовательная или random, чтение/запись, размер блока, занятый объём и допустимая задержка. Затем определяют usable, spare и запас роста. Не оставляйте выбор RAID продавцу без этих условий.
В спецификацию входят PERC, защита кеша, диски, carriers, кабели, backplane и версии. Для готового сервера Dell PowerEdge проверьте фактически установленный комплект, а не только название модели.
Приёмка включает health, политику кеша, уведомления, производительность и согласованный аварийный сценарий. Backup восстанавливают отдельно. В журнале сохраняют карты слотов, параметры virtual disk и исходные результаты.
После покупки мониторят degraded-состояние, ошибки и длительность rebuild. Правильный RAID — это поддерживаемый состав, понятный отказ и обслуживаемый процесс. Одной буквы или цифры в заказе для защиты бизнес-данных недостаточно.
Частые вопросы
Какой RAID выбрать для Dell PERC?
По нагрузке, полезной ёмкости, допустимым отказам и поддержке контроллера. Сравните RAID 5, 6 и 10 на одинаковых дисках и в резервном режиме.
RAID 5 или RAID 10 быстрее?
Зависит от операций и комплекта. RAID 10 часто рассматривают для мелкой записи, но решение требует измерения задержки целевого приложения.
RAID 6 выдержит любые два отказа?
В пределах одного корректно работающего RAID 6 защита предусматривает любые два отказа дисков. Другие причины потери данных этим не исключаются.
RAID 10 выдержит два отказа?
Если не потеряны оба диска одной зеркальной пары. Два отказа в одной паре выходят за защиту обычной схемы.
Где диск чётности в RAID 5?
Чётность распределяется между дисками. Один выделенный постоянно parity-диск — неверная схема для RAID 5.
Сколько usable у восьми дисков по 4 ТБ?
До файловую систему и резервов: 28 ТБ RAID 5, 24 ТБ RAID 6, 16 ТБ обычного RAID 10.
Hot spare увеличивает usable?
Нет. Он резервируется для восстановления и должен учитываться отдельно от активных дисков.
Rebuild закончится за ночь?
Гарантировать нельзя. Длительность зависит от объёма, реальной скорости, нагрузки и настроек. Нужен собственный тест.
UPS разрешает включить forced write-back?
UPS не заменяет все механизмы защиты кеша. Политика должна соответствовать поддерживаемой конфигурации и состоянию контроллера.
Можно смешивать диски разной ёмкости?
Поддержка и usable зависят от реализации. Не считайте большую ёмкость полностью доступной без проверки правил PERC и состава.
PERC подходит для любого NVMe?
Нет. Проверяют поколение контроллера, backplane, кабели, платформу и режим подключения.
RAID заменит резервные копии?
Нет. Нужны независимые копии и проверка восстановления после потери всей системы или изменения данных.