Как выбрать сервер резервного копирования Dell: PowerProtect Data Domain или репозиторий на PowerEdge?
Сервер резервного копирования выбирают по тому, какие данные и за какое время нужно восстановить. Ёмкость репозитория, скорость записи backup и скорость возврата приложений — разные показатели. Система, которая успевает закончить ночное копирование, может не выполнить требуемый срок восстановления после аварии.
Для Dell есть два разных подхода: специализированное хранилище PowerProtect Data Domain и репозиторий на PowerEdge с подходящим backup ПО. Первый предлагает специализированный стек хранения и интеграции; второй даёт возможность построить серверный репозиторий под выбранное ПО. Выбор определяется политикой хранения, восстановлением, защитой от удаления и полной стоимостью эксплуатации.
До подбора оборудования зафиксируйте защищаемый объём, ежедневные изменения, сроки хранения, RPO и RTO по приложениям. Затем проверьте реальное восстановление, включая зависимости. Backup нужен для возвращения данных; успешный статус задания — только промежуточный результат.
RPO и RTO: какие требования поставить перед покупкой?
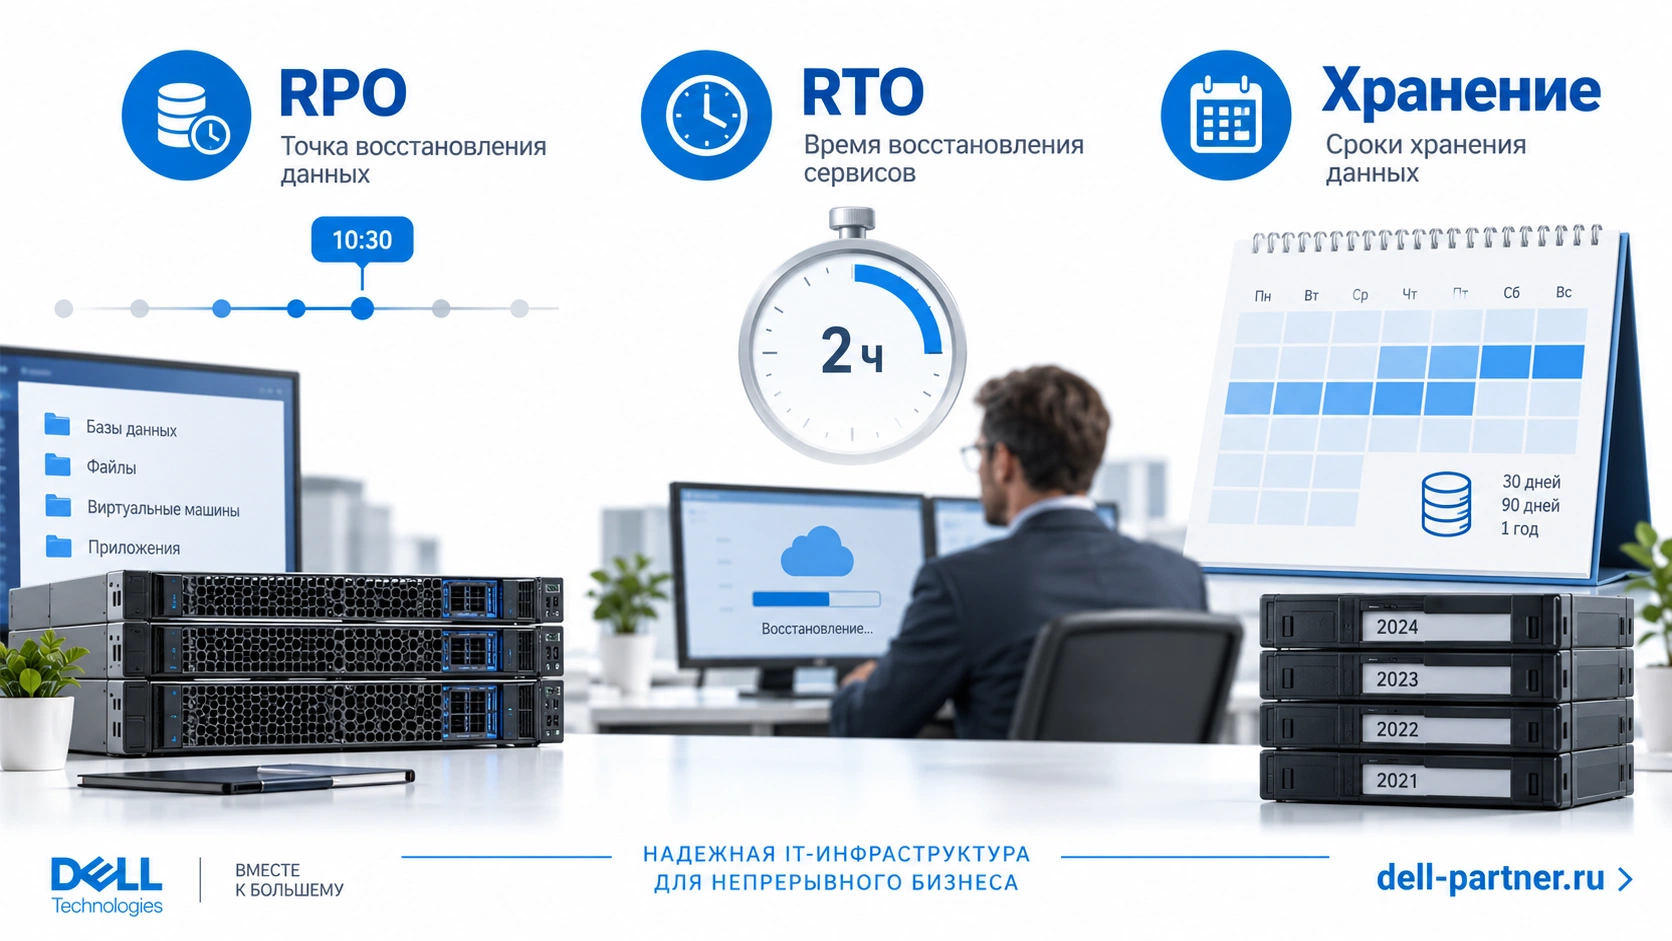
RPO — допустимая потеря данных во времени, RTO — целевое время восстановления сервиса. Если RPO составляет четыре часа, резервная копия раз в сутки не выполняет это требование. Если RTO два часа, копирование файлов за два часа ещё не гарантирует запуск приложения в тот же срок.
Разделите приложения по критичности. Для системы продаж и архивных документов могут быть разные цели. Попытка назначить всем данным самый строгий режим увеличивает расходы; одинаково редкое копирование всего массива оставляет критичные сервисы недостаточно защищёнными.
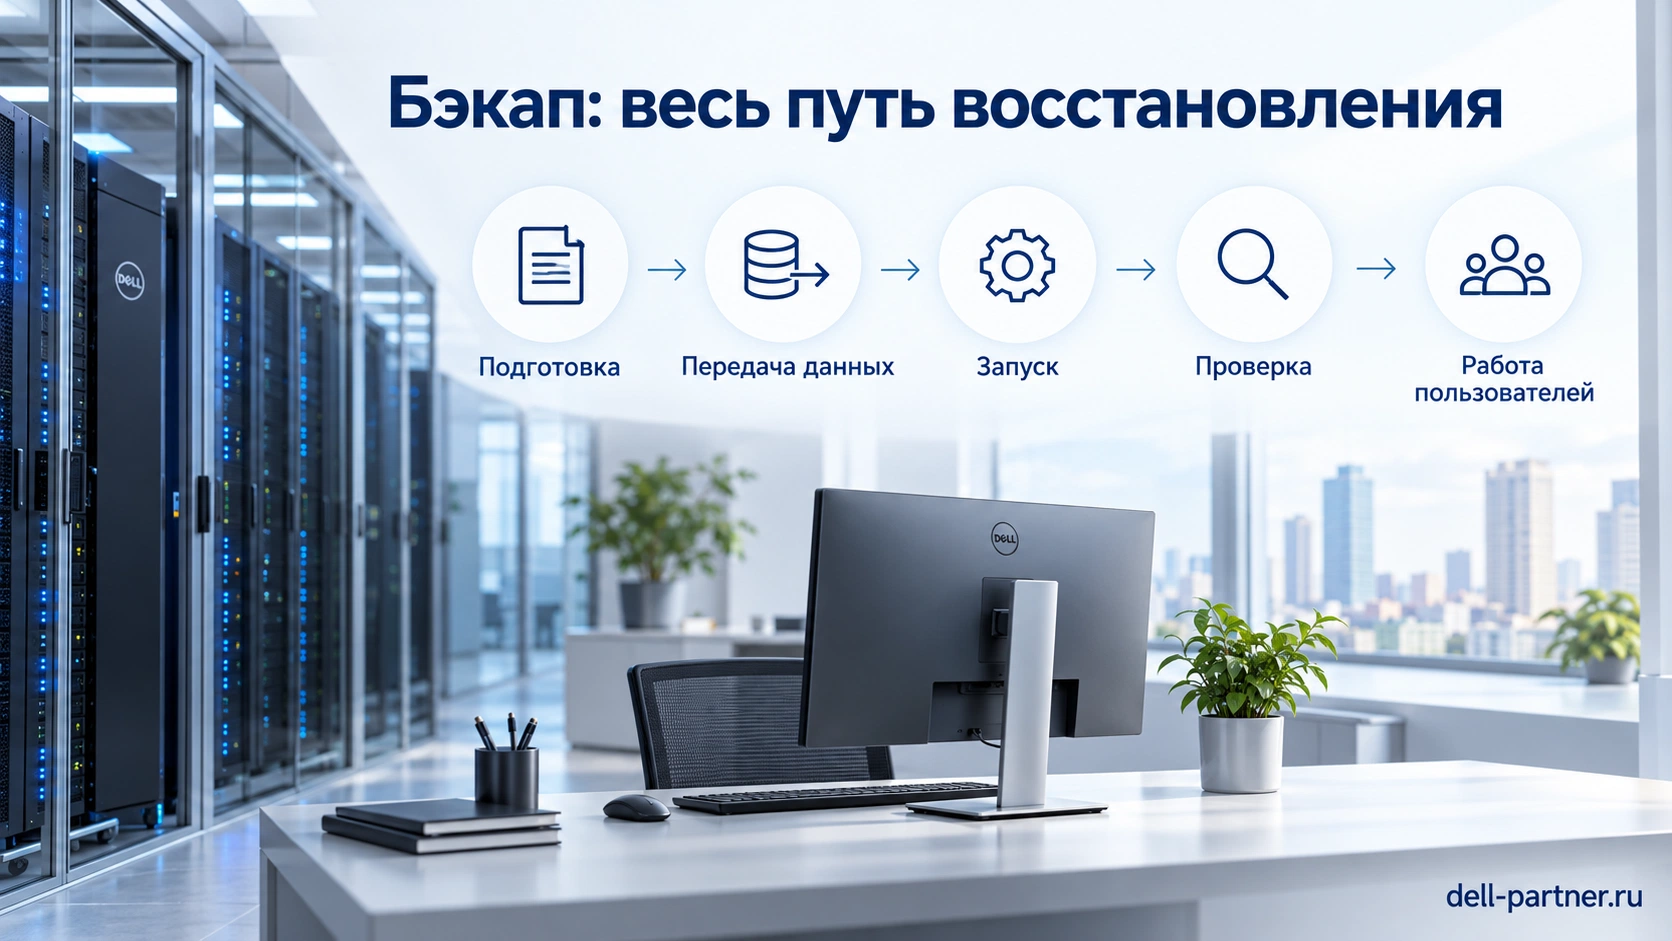
RTO включает обнаружение инцидента, выбор точки, подготовку целевой инфраструктуры, перенос данных, запуск зависимостей и проверку приложения. Уточните, кто принимает решение о восстановлении и где находятся инструкции/доступы, если основная инфраструктура недоступна.
RPO также проверяется по фактическим заданиям. Пропущенная или повреждённая последняя копия увеличивает потерю данных. Мониторинг должен замечать не только аварии оборудования, но и несостоявшееся резервное копирование.
| Группа данных | Условное RPO | Условное RTO | Что проверить |
|---|---|---|---|
| Критичное приложение | 1 час | 2 часа | Частоту копий и запуск зависимостей |
| Рабочие документы | 4 часа | 8 часов | Возврат файлов и прав |
| Архив | 24 часа | 48 часов | Доступ к нужной исторической версии |
| Конфигурация IT | После изменений | До запуска зависимостей | Доступность ключей и инструкций |
PowerProtect Data Domain или PowerEdge: чем отличаются проекты?
Data Domain — специализированная платформа хранения резервных копий с дедупликацией и интеграциями backup ПО. Она не заменяет управление заданиями и знание того, как восстанавливается приложение. Наличие DD в стойке не означает, что все серверы уже защищены.
PowerEdge используется как вычислительная и дисковая платформа репозитория. Поведение задают ОС, файловая система, backup ПО, контроллер, диски и политики. Такой вариант позволяет проектировать роли и ёмкость, но ответственность за совместимость и обслуживание всего состава должна быть определена.
Для существующего backup-продукта проверьте поддерживаемые версии DD OS, integration/plugin и сценарии восстановления. Для серверного репозитория — требования к ОС, storage и защите. Один общий список «поддерживает Veeam» недостаточен для любого релиза и режима.
Сравнивайте проекты с одинаковыми RPO, срок хранения и RTO. Если один вариант хранит семь дней, а другой — месячные и годовые точки, разница цены не описывает стоимость одной и той же услуги.
| Критерий | PowerProtect Data Domain | PowerEdge с backup ПО |
|---|---|---|
| Архитектура | Специализированный стек backup storage | Сервер, ОС и выбранное ПО |
| Сокращение данных | Собственная дедупликация/сжатие | Зависит от программного состава |
| Защита хранения | Проверить Retention Lock и лицензии | Проверить immutable/hardened режим |
| Совместимость | DD OS, plugin, версия backup | ОС, файловую систему, controller, backup |
| Эксплуатация | Платформа и интеграция | Весь серверный стек |
| Приёмка | Реальный backup и restore | Те же задачи на том же наборе |
Сравнивайте платформы на одинаковом требовании возврата сервиса. Если Data Domain и PowerEdge предлагают разные сроки хранения, независимость копий и сценарий восстановления, разница цены относится к разным проектам. Сначала задайте общий результат, затем уточняйте состав оборудования и ПО.
Для PowerEdge нужна схема репозитория, включая файловую систему, защиту дисков, роли, обновления и восстановление управления. Специализированная система также требует совместимого ПО, соединения и эксплуатации. Ни один корпус не становится полноценной программой защиты только после подключения к сети.
Как рассчитать ёмкость: почему 30 ТБ данных не означают репозиторий 30 ТБ?
Хранятся не только текущие данные, но и изменения, полные точки, GFS-периоды, метаданные и запас на операции. Начните с политики: сколько ежедневных, еженедельных и месячных точек требуется, как строятся full/incremental и когда освобождается место.
Учебная простая цепочка: базовый объём 30 ТБ, ежедневное изменение 1,5 ТБ, одна полная копия и 29 инкрементов дают 30 + 29 × 1,5 = 73,5 ТБ логических данных до уменьшения объёма и служебных расходов. Это не универсальный расход всех backup-продуктов, а способ показать роль срок хранения.
Дополнительные full и GFS меняют расчёт. Block cloning, synthetic full и дедупликация могут сократить физический расход, но их условия проверяются для выбранного стека. Нельзя считать каждый full полной физической копией во всех архитектурах, как нельзя обещать идеальную экономию всем данным.
Резерв учитывает новые данные, временное перекрытие цепочек, изменение политики и период, когда immutable-файлы ещё нельзя удалить. Проектирование репозитория впритык к нормальному объёму создаёт риск остановки backup в самый неподходящий момент.
| Компонент | Как оценить | Не забыть |
|---|---|---|
| Текущие данные | Фактически защищаемый объём | Исключения должны быть согласованы |
| Изменения | Наблюдаемый daily change | Пики закрытия периода |
| Retained points | Full/incremental/GFS | Политика продукта и сроки |
| Служебные расходы | Metadata, файловую систему, операции | Не путать raw и usable |
| Резерв | Рост и перекрытие цепочек | Immutability может продлить удержание |
Как оценить дедупликацию и не купить слишком маленький DD?
Коэффициент дедупликации зависит от повторяемости данных, структуры backup, сжатия, шифрования и срока хранения. Каталог документов, VM с похожими ОС и уже сжатые медиофайлы ведут себя по-разному.
Не применяйте рекламный коэффициент к каждому набору. Получите результаты пилота или используйте консервативную модель с явно указанными допущениями. Для закупки важно, какие данные входят в расчёт и сколько времени наблюдалась политика хранения.
Если коэффициент принято считать как логический объём / физический, то 73,5 ТБ при условном 3:1 дают 24,5 ТБ до дополнительных расходов. Но если фактически получится 1,5:1, потребуется уже 49 ТБ. Оба числа — арифметические сценарии, не прогноз DD для вашего корпуса данных.
Разделяйте дедупликацию источника, транспортный трафик и место на target. Меньше переданных байтов не означает автоматически такое же уменьшение всего репозитория. Согласуйте, какой показатель используется в коммерческом расчёте.
Какую скорость backup и сети заложить для ночного окна?
Определите объём, который нужно прочитать и передать за доступное время. Для 2 ТБ за четыре часа средняя требуемая скорость составляет примерно 139 МБ/с в десятичных единицах, без накладных расходов. Пики, другие задачи и время обработки требуют запаса.
Теоретический предел 1 GbE — 125 МБ/с, 10 GbE — 1,25 ГБ/с до накладных расходов. Если задача уже требует 139 МБ/с, один гигабитный путь не обеспечивает такой поток без уменьшения данных или другого изменения архитектуры. Скорость target сама по себе этого не исправляет.
Измерьте чтение с production, обработку proxy/шлюз доступа, передачу и запись. Источник может ограничивать backup раньше репозитория. Слишком много одновременных заданий также способно ухудшить и backup, и рабочие приложения.
DD Boost меняет обработку и сетевую передачу в поддерживаемой интеграции, но не гарантирует ускорение любого задания. Параллелизм, версии и тип восстановления должны быть частью пилота. Не увеличивайте concurrent tasks без измерения очередей и нагрузки.
Что важнее для RTO: скорость записи или скорость восстановления?
Восстановление может читать backup иначе, чем он записывался. Возврат отдельного файла, полного VM и моментальный запуск имеют разный профиль. Максимальная скорость последовательной записи не подтверждает такой же результат для случайного чтения.
Для Data Domain учитывайте дедуплицированную архитектуру и поддерживаемые механизмы restore backup-продукта. Для PowerEdge — диски, controller cache, RAM, сеть и тип операций. Сравнивайте конкретный сценарий, а не одно рекламное число ТБ/ч.
Если требуется восстановить условные 3 ТБ за два часа, только перенос данных требует средней скорости около 417 МБ/с. В эти два часа ещё должны поместиться подготовка и запуск, поэтому реальная цель по переносу будет строже. Это пример для планирования, не обещание модели.
Не забудьте место, куда выполняется restore. Репозиторий может читать быстро, а целевой datastore — записывать медленно. Для аварии с потерей основной СХД нужен заранее определённый запас оборудования или другой recovery target.
| Сценарий | Основное измерение | Дополнительная зависимость |
|---|---|---|
| Отдельный файл | Поиск и возврат версии | Права и целевая папка |
| Полная VM | Чтение backup и запись target | Сеть/storage назначения |
| Запуск из backup | Отзывчивость временного режима | Random I/O и последующая миграция |
| База данных | Consistency и время запуска | Журналы, зависимости, проверка |
| Массовая авария | Одновременный restore | Порядок служб и запас ресурсов |
RTO начинается не с первого прочитанного блока, а с принятого определения аварии и запуска процедуры. В нём есть поиск нужной копии, подготовка доступа и площадки, передача, запуск зависимостей и проверка бизнес-операций. Быстрый restore диска не гарантирует, что сотрудники уже могут работать.
Immutable backup, Retention Lock и hardened repository: что защищает от удаления?
Неизменяемость ограничивает удаление или изменение сохранённых копий в установленный период. Механизм зависит от платформы и режима. Это не синоним полного отсутствия риска: ошибки политики, доступа и восстановления всё равно требуют проверки.
У Data Domain различаются Retention Lock Governance и Compliance. Governance допускает определённые действия уполномоченных администраторов, Compliance применяет более строгие ограничения. Не называйте эти режимы одинаковыми по защите; проверьте модель, версии, лицензии и процедуру эксплуатации.
Hardened repository на Linux имеет требования к локальному или подключённому блочное хранилище, файловой системе и authentication. SMB/NFS-папку нельзя автоматически считать таким же репозиторием. Защита создаётся совместимым программным и аппаратным составом, а не установкой Linux сама по себе.
Срок неизменяемости должен согласовываться с срок хранения и свободным местом. Если копии нельзя удалить ещё несколько недель, уменьшение срок хранения в интерфейсе не всегда сразу освобождает ёмкость. Учтите это в запасе и аварийных процедурах.
Immutable-режим нужно сопоставить со сроком, правами и конкретным типом копии. Разные продукты и режимы по-разному продлевают защиту активной цепочки и обслуживают старые точки. Не переносите один пример настройки на любой формат данных. При расчёте места важно, какие файлы ещё нельзя удалить, даже если их полезность для обычного расписания уже закончилась.
Нужна ли отдельная копия вне основной инфраструктуры?
Репозиторий рядом с production может пережить отказ диска, но остаться в одном домене риска с источником: одна площадка, учётные записи, администраторские доступы или электропитание. Проектируйте независимость копий по угрозам, которые действительно нужно пережить.
Принцип 3-2-1 полезен как отправная точка: несколько копий, разные носители/системы и одна копия вне основной площадки. Расширения с неизменяемой или offline-копией и проверкой ошибок помогают уточнить политику. Это архитектурные ориентиры, а не автоматическая гарантия восстановления.
Репликация не заменяет исторические точки. Если удаление или повреждение быстро переносится на вторую систему, обе копии могут содержать ту же проблему. Проверьте задержку обнаружения и доступный срок хранения.
Отдельно сохраните configuration backup, ключи, учётные данные восстановления и инструкции в допустимой защищённой форме. Если они доступны только через потерянную инфраструктуру, даже хорошее storage не завершает recovery-проект.
Какие диски, RAID, CPU и RAM нужны репозиторию PowerEdge?
Сначала уточните требования выбранного backup ПО. Репозиторий с преимущественно последовательной записью и длинным срок хранения может иметь иной состав, чем система для активного instant recovery и частых restore.
Для большого объёма HDD дают доступную ёмкость, SSD полезны там, где важны случайные операции и метаданные. Объём и RAID считают по полезному месту, включая резервирование. RAID защищает от части аппаратных отказов; удалённую копию или immutability он не заменяет.
CPU и RAM обслуживают программные роли, потоки, compression/encryption и файловую систему. Не назначайте один объём RAM любому числу защищаемых VM. Проверьте concurrent tasks, размер данных и поддерживаемые требования.
В спецификации PowerEdge должны быть загрузочный том, диски данных, PERC/HBA в согласованном режиме, защита кеша, NIC, кабели и блоки питания. Не объединяйте роли без проверки программных ограничений, особенно для hardened repository.
Как проверить согласованность приложений и историческую точку?
Успешный образ VM не всегда означает корректную точку базы данных. Приложение может требовать application-aware processing, собственные механизмы backup или журналы. Эти условия согласуют с владельцем системы до настройки заданий.
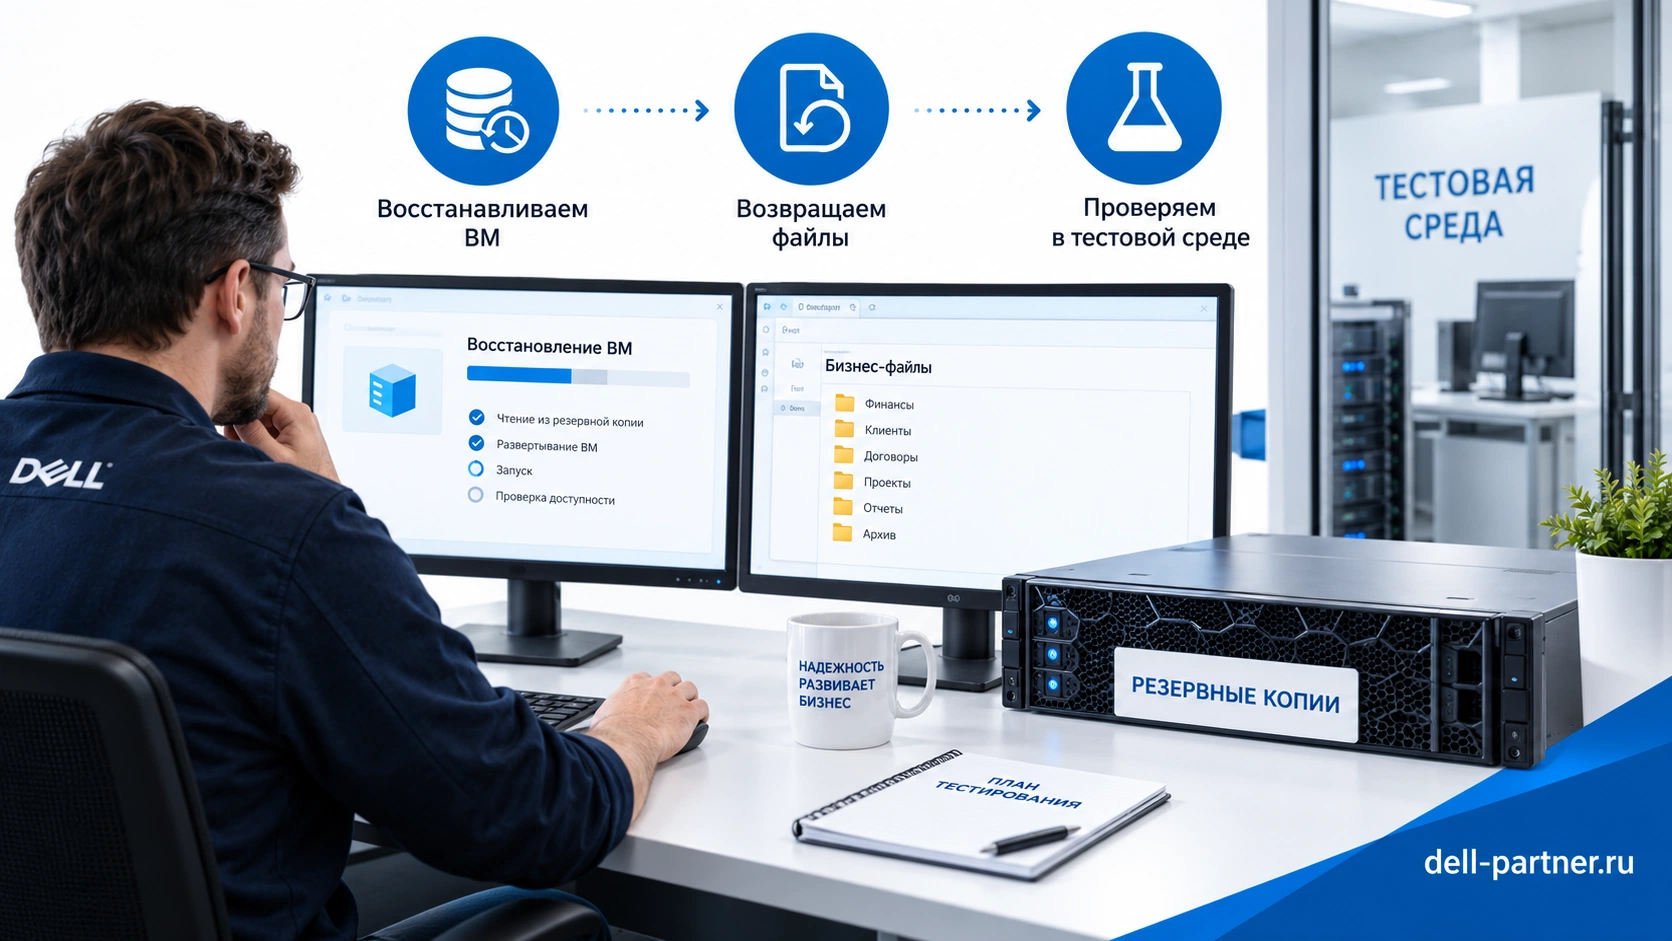
Проверьте восстановление на изолированной среде: база открывается, транзакции и файлы соответствуют выбранной точке, зависимости работают. Для сложного приложения включите проверку со стороны пользователя, а не только запуск ОС.
Срок обнаружения ошибки также важен. Если повреждение нашли через три недели, срок хранения семь дней не даёт нужной исторической версии. Политика должна учитывать бизнес-процесс, а не только текущий свободный объём дисков.
Изоляция recovery-среды предотвращает конфликт с production: дублирование адресов, служб, scheduled jobs и внешних отправок. В тесте восстанавливают работоспособность контролируемо, сохраняя границы доступа.
Как провести приёмку backup-системы?
Для пилота возьмите несколько типов данных: обычную VM, тяжёлую базу, набор мелких файлов и большой файл. Повторите backup, restore и работу при одновременных заданиях. Укажите версии и настройки, чтобы результат был воспроизводим.
Проверьте не только последнюю точку, но и более старую. Снимите время поиска, чтения, передачи, записи и запуска. Для RTO нужен полный цикл, включая действия администратора.
Протестируйте защиту копий на безопасном отдельном наборе и в рамках согласованных ролей. Подтвердите, какие действия разрешены администратору, какие ограничены и когда данные могут освобождаться. Не проводите эксперимент с удалением production-backup ради демонстрации.
Сохраните протокол и расписание повторных проверок. Система меняется: растут данные, обновляется ПО и добавляются приложения. Успешный пилот сегодня требует дальнейшего контроля, чтобы RPO/RTO оставались достижимыми.
| Этап | Проверить | Результат |
|---|---|---|
| Копирование | Окно, влияние на production | Задания завершены с запасом |
| Restore файла | Версия, права, время | Данные пригодны пользователю |
| Restore VM/базы | Согласованность и зависимости | Приложение работает |
| Историческая точка | Retention и поиск | Нужная версия доступна |
| Защита копий | Роли и срок immutability | Поведение соответствует политике |
| Аварийная схема | Отдельная копия и доступы | Recovery возможен без основного контура |
Как посчитать резервный репозиторий по изменениям, а не по объёму исходных дисков?
Для предварительной модели нужны защищаемые данные, ежедневное изменение, число полных копий, срок точек и дополнительные долгосрочные копии. Размер выделенных виртуальных дисков отличается от реально записанных данных. Также важны исключения, сжатие и дедупликация. Эти величины нужно разделять, чтобы не купить оборудование по неправильной базе.
Учебный пример:10 ТБ исходных данных, каждый день новые изменённые блоки занимают 2%, а цепочка содержит одну полную и 29 инкрементальных точек. Без сокращения и дополнительных полных копий ориентир —10 +29×0,2 =15,8 ТБ логических данных. Служебные расходы, рабочие операции и отдельные долгосрочные копии в эту сумму ещё не включены. Это модель конкретного расписания, а не формула всех backup-систем.
При ежедневном изменении 5% тот же расчёт даст 24,5 ТБ. Большая разница возникает без изменения исходных 10 ТБ. Но синтетические полные копии, дедупликация и поддерживаемое ускоренное создание точек могут поменять физический расход. Именно поэтому число процентов требует измерения выбранным ПО, а не оценки по числу открытых документов.
Срок защиты также влияет на освобождение места. Если копия ещё неизменяема, обычная очистка может не удалить её в ожидаемый день. Сопоставьте срок хранения, immutability, активную цепочку и долгосрочные точки. Репозиторий должен выдерживать предусмотренные операции и возврат к штатному расписанию после задержки.
Планируйте сценарий неблагоприятного сокращения данных. Зашифрованные и уже сжатые файлы не обязаны давать коэффициент, полученный на другой нагрузке. Для первоначального заказа полезны пилот и запас, рассчитанный из явных условий. Увеличение защитного периода после закупки также требует пересмотра бюджета.
| Статья бюджета | Изменение 2% | Изменение 5% |
|---|---|---|
| Полная копия | 10 ТБ | 10 ТБ |
| Ежедневное изменение | 0,2 ТБ | 0,5 ТБ |
| 29 инкрементов | 5,8 ТБ | 14,5 ТБ |
| Логическая сумма | 15,8 ТБ | 24,5 ТБ |
| Ещё нужно учесть | Операции, резерв, защиту и долгосрочные точки | Те же дополнительные условия |
Окно backup и RTO: два отдельных расчёта скорости
Ночное копирование работает с потоком изменений по выбранному расписанию. Восстановление способно потребовать полный объём сервиса, а не вчерашние изменённые блоки. Поэтому сеть и чтение репозитория проверяют отдельно для каждого направления. Высокая скорость записи не подтверждает такую же скорость возврата данных.
Пусть за 8 часов нужно передать 6 ТБ изменений. Средняя полезная скорость только передачи — около 208,3 МБ/с. Если доступны лишь 6 часов из окна из-за подготовки и других заданий, ориентир возрастает до 277,8 МБ/с. Длительность нескольких одновременно выполняемых задач и доступ к источникам добавляют отдельные ограничения.
Для восстановления 4 ТБ за 2 часа чистой передачи нужно около 555,6 МБ/с. Но если общий RTO равен 2 часам и 30 минут уходят на подготовку и проверку, на данные остаются 1,5 часа; ориентир становится 740,7 МБ/с. Это арифметические примеры десятичных ТБ/МБ, не гарантия конкретной сети или устройства.
Реальная скорость включает чтение, разбор цепочки, передачу, запись на целевой ресурс и обработку приложения. Самый медленный этап ограничивает весь путь. При нескольких сервисах порядок запуска меняет нагрузку: одновременное восстановление всего парка может оказаться хуже приоритетного возврата критичных ролей.
Согласуйте сценарий «главная площадка недоступна». Откуда берётся система управления backup, как получают доступ к копии и где запускают восстановленный сервис? Если ответ предполагает работающий компонент потерянной площадки, проект ещё не описывает нужную аварию. Тест должен начать с тех ресурсов, которые действительно остаются доступными.
Независимая копия: какие общие зависимости нужно исключить?
Отдельный каталог или VLAN не являются полной независимостью. Проверьте оборудование, питание, учётные записи, доменные роли, администраторские права и путь управления. Если один общий аккаунт может удалить и рабочие данные, и все их копии, защита остаётся зависимой от этого аккаунта.
Для неизменяемого хранения важно, кто назначает срок, как обслуживается доступ и какая операция может снять или изменить защиту. Разные продукты дают разные режимы и полномочия. Отказ оборудования, ошибка сотрудника и компрометация управления требуют отдельных сценариев. Слово immutable в предложении не описывает все эти случаи.
Вторая площадка также должна быть проверяемой. Передача копии за пределы основной системы помогает только при доступе к нужной исторической точке и возможности её прочитать. Если копия автоматически повторяет повреждение или недоступна без потерянных ключей, её расположение не решает весь вопрос.
Проверяйте восстановление без исходных паролей и компонентов в согласованном аварийном сценарии, сохраняя штатные правила безопасности. Должны быть определены ответственные, порядок доступа, место хранения ключей и журналы действий. Статья не предлагает обходить управление; она объясняет, почему организационный доступ входит в проект оборудования.
Тест независимой копии проводят регулярно по согласованному расписанию и после существенного изменения системы. Нет универсальной периодичности, которая подходит любому сервису. Частоту связывают с важностью, скоростью изменения инфраструктуры и допустимыми рисками. Главное — зафиксировать последний успешный сценарий, а не полагаться на давнюю зелёную задачу backup.
Как выбрать диски и RAM репозитория PowerEdge по операциям?
Репозиторий выполняет не только последовательную запись новых файлов. Возможны чтение для восстановления, проверка целостности, создание новых точек, обслуживание цепочек и удаление доступных старых данных. Эти операции могут совпадать и иметь разные требования к задержке и памяти. Профиль только ночной записи описывает проект частично.
Накопители и RAID выбирают по поддерживаемому стеку и целевым операциям. Окончательную схему массива подробно рассматривают в отдельной статье; здесь важно не потерять рабочие условия репозитория. Например, полезная ёмкость должна проходить одновременно с временем восстановления и состоянием после отказа диска.
CPU и RAM зависят от ПО, числа задач, обработки данных и архитектуры. Нельзя назначить фиксированное число гигабайт на любой терабайт исходников. Для пилота используют поддерживаемую конфигурацию, измеряют нагрузку и проверяют дополнительные задания. Максимум интерфейса накопителя не равен скорости обработки конкретной цепочки.
Проверяйте сеть и целевую запись вместе. Если репозиторий читает быстро, а восстановленный datastore записывает медленно, новый backup-сервер не устранит это ограничение. Аналогично источник может ограничивать ночное копирование даже при свободной полосе назначения. Разделение этапов экономит бюджет на лишние замены.
Для отказа диска или обслуживания оцените, сколько времени система работает в изменённом состоянии и какие операции сохраняет. Перестроение массива может влиять на восстановление приложений. В спецификации должен быть предусмотрен этот режим, если он входит в требуемый уровень доступности.
Что проверить при переходе на новую backup-систему Dell?
Сначала уточните, какие старые точки останутся доступными. Новый репозиторий и новое ПО не всегда автоматически понимают прежние цепочки. Для перехода нужно решение по формату, срокам хранения и способу восстановления истории. Простое копирование файлов не доказывает пригодность точки для выбранного стека.
Создайте тестовую копию нового проекта и восстановите критичный сервис. Проверьте согласованность приложения, не только загрузку ОС. Для базы важна рабочая операция и нужная дата; для файлов — содержимое и права. Программа приёмки должна включать владельца бизнес-процесса, который подтверждает результат.
Переключайте расписание с понятной границей. Что защищено старой системой, что новой и где находится последняя успешная точка? Дублирование части периода может быть оправдано, но его ёмкость и работа также учитываются. Нельзя отключать старый проект только потому, что новый интерфейс показывает успешную первую задачу.
Проверьте уведомления, ответственных и реагирование на отсутствие новой копии. Успех backup-задания и актуальность всей защиты — разные вещи: один сервис мог быть исключён из политики или больше не попадать в неё. Инвентаризация защищаемых ресурсов должна сверяться с реальным парком.
Итог миграции — новая программа защиты, доступная история, проверенное восстановление и согласованный вывод старого оборудования. Сохраните протокол, версии, карту зависимостей и ограничения. Это превращает покупку Dell в работающий сервис восстановления, а не в перенос архивов между корпусами.
Как сравнить ежедневные, недельные и долгосрочные копии без двойного счёта?
Для каждого класса укажите срок, расписание и способ хранения. Ежедневные точки помогают оперативному возврату, недельные и месячные могут закрывать другую историю. Но количество точек не равняется количеству полных физических копий в любой системе. Объединение, дедупликация и удержание цепочек меняют расход.
В предварительной таблице отделяйте логический размер от физической модели продукта. Если условно хранить 12 независимых полных копий по 10 ТБ без сокращения, получится 120 ТБ. Если используется другое представление и общий набор блоков, этот расчёт не описывает фактическое устройство. Он полезен как явная граница допущения, а не как гарантированный бюджет DataDomain.
Долгосрочная точка может удерживать связанные файлы по правилам выбранного ПО. Поэтому простое сложение полных и ежедневных копий способно как завысить, так и занизить потребность. Нужно понять, какие данные реально сохраняются и когда могут освободиться. Для неизменяемого режима эти сроки сопоставляют с защитой.
После пилота сравните фактические изменения и сокращение на разных типах данных. Документы, виртуальные машины и зашифрованные архивы способны дать разную картину. Один коэффициент общего теста не следует переносить на новое подразделение с другим набором. Уточняйте бюджет по мере добавления сервисов.
Укажите, какая история нужна после миграции и прекращения старого договора ПО. Требование хранить точку несколько лет включает возможность прочитать её через весь период. Файлы без доступного инструмента, ключей и рабочего способа восстановления не завершают это обязательство.
Полный RTO: пример, где новая сеть не решает весь срок восстановления
Предположим, требуемый возврат сервиса —120 минут. Подготовка занимает 20 минут, передача данных 90, запуск 15, проверка 25. Итог 150 минут, и проект не проходит. Увеличение скорости передачи помогает только одной части пути; остальные 60 минут остаются.
Если передачу сократить до 60 минут, получится 120. Но это уже предел без запаса на непредусмотренные задержки. Окончательный проект должен показать устойчивый согласованный результат, а не только одну идеальную попытку. Реальные периоды берут из теста и заранее принятого определения RTO.
Проверьте зависимости: идентификация,DNS, базы, приложения и рабочие места. Запускать пользовательский сервис до готовности его базы иногда бесполезно. Порядок может менять скорость и количество неуспешных действий. В план включают ответственного и критерий готовности каждого этапа.
Для отдельных сервисов приоритет отличается. Сначала может быть нужен небольшой критичный набор, затем остальной парк. Такой сценарий способен быстрее вернуть основные операции, даже если полное восстановление всех VM занимает дольше. Но его нельзя представить как выполнение прежнего требования ко всем сервисам одновременно.
Тест проводится в условиях доступных после выбранной аварии ресурсов. Если в нём использована исправная основная СХД, а проект предусматривает её потерю, полученная скорость не описывает нужный сценарий. Полезная покупка DD или PowerEdge должна проходить именно его.
| Этап | Первоначально | После изменения передачи |
|---|---|---|
| Подготовка | 20 минут | 20 минут |
| Передача | 90 минут | 60 минут |
| Запуск | 15 минут | 15 минут |
| Проверка | 25 минут | 25 минут |
| Итого | 150 минут | 120 минут |
| Что ещё проверить | Требование не выполнено | Устойчивость и резерв времени |
Копия создана, но приложение не работает: что было пропущено?
Копирование состояния диска не всегда означает согласованное состояние приложения. Для базы и связанных сервисов требуется предусмотренный механизм защиты и восстановления. Загрузившаяся ОС или доступный том — промежуточный результат, а не доказательство правильности всех данных.
Проверьте действия, важные для владельца процесса: вход, чтение, запись и характерную операцию. Нужная историческая точка должна соответствовать требованию, включая допустимую потерю данных. Если восстановлен вчерашний файл при согласованном 15-минутном RPO, успешная читаемость не выполняет требование свежести.
Сохраните журнал согласованности и исключений задания. Некоторые ресурсы могут быть пропущены, недоступны или защищены другим механизмом. Общая успешная отметка не заменяет сверку состава защищаемых систем. Особенно важно делать её после изменений VM и приложений.
Если необходимы журналы транзакций или иной способ получить более свежую точку, его проектируют вместе с приложением. Не следует объявлять обычную ночную полную копию достаточной для любого малого RPO. Аппаратный репозиторий хранит нужные данные, но не придумывает отсутствующую историю.
Отдельно проверяйте возвращение сервиса в штатную защиту после восстановления. Новая VM или перенесённый набор должен вновь попадать в предусмотренные задания. В противном случае успешная аварийная операция оставит систему без следующих копий.
Что делать, если потеряна система управления резервным копированием?
Проект должен описать, как получить конфигурацию, доступ к репозиторию, ключи и нужный инструмент без потерянного сервера управления. Нельзя рассчитывать на компонент, который находится в том же аварийном наборе и пока не восстановлен. Отдельный корпус репозитория не закрывает этот организационный путь сам.
Проверьте предусмотренный экспорт или копию конфигурации и процедуру восстановления управления для выбранного ПО. Версии и лицензии могут влиять на чтение истории, поэтому их сохраняют в плане. Это не означает хранить пароли в открытом документе: нужен согласованный защищённый доступ.
В учебном тесте начинайте с действительно оставшихся ресурсов и назначенных сотрудников. Если только один специалист знает процедуру и недоступен в выбранный момент, организационный RTO не обеспечен. Нужна воспроизводимая инструкция и проверяемое распределение обязанностей.
Независимые права и неизменяемость могут ограничивать аварийные действия. Их смысл состоит в защите, поэтому восстановление нельзя строить на отключении всех правил доступа по первой просьбе. Поддерживаемая процедура должна проходить и функциональный, и организационный контроль.
Итог — документированный путь от доступной копии к рабочему сервису и последующему штатному управлению. Это полезный критерий сравнения проектов: специализированная платформа и репозиторий PowerEdge могут иметь разную эксплуатационную работу, которую следует включить в стоимость.
Как наблюдать backup-систему после закупки?
Сверяйте защищаемый парк с реальным, дату последней нужной точки, длительность задач, свободное место и результаты восстановления. Количество успешных заданий за месяц мало говорит о системе, которую случайно исключили из политики. Инвентаризация должна оставаться актуальной.
Наблюдайте темп заполнения и срок возможного расширения. Если репозиторий растёт быстро, позднее уведомление не оставит времени на поставку и обслуживание. Порог связывают с реальным темпом и допустимыми действиями. Очистка неизменяемых данных может быть недоступна до срока.
Сохраняйте результаты контрольного восстановления с версией ПО и составом системы. После обновления, изменения дисков, сети или приложения повторяют соответствующий сценарий. Предыдущий результат не подтверждает любую новую комбинацию.
Проверяйте оповещения: получатель, время реакции, ответственные и закрытие события. Сообщение, отправленное в неиспользуемую папку, не сокращает аварийный период. Контроль требуется как для ошибок копий, так и для отсутствия ожидаемого нового задания.
По результатам корректируйте модель ёмкости и сроков, сохраняя исходные требования. Рост данных или новые приложения могут потребовать другой комплект. Такой пересмотр помогает расширять Dell систему по измеренному процессу и не принимать старую демонстрационную скорость за пожизненную гарантию.
Как выбрать и купить Dell для резервного копирования серверов?
Передайте защищаемый объём, daily change, политику full/incremental/GFS, backup ПО с версиями и цели RPO/RTO по приложениям. Дополните условиями размещения, внешней копией и требованиями к неизменяемости.
В каталоге PowerProtect Data Domain сравнивайте поддерживаемую ёмкость и интеграции. Для серверного репозитория рассмотрите Dell PowerEdge с конкретным программным стеком и дисковым составом.
Попросите две сопоставимые спецификации и приёмку восстановления. В предложении должны быть оборудование, лицензии, backup-роли, сеть, резервное питание, поддержка и измеряемые цели. Главный критерий — возвращение рабочих данных в согласованный срок, а не максимальный объём корпуса.
Частые вопросы
Чем RPO отличается от RTO?
RPO задаёт допустимую потерю данных во времени; RTO — срок восстановления сервиса. Частота backup и скорость restore отвечают на разные требования.
Data Domain заменяет backup ПО?
Нет. Это платформа хранения и интеграций. Нужны задания, политика и процедура восстановления приложения.
Можно ли использовать PowerEdge как репозиторий?
Да, с совместимым программным стеком, storage и политикой. Проверьте требования выбранного продукта и ограничение ролей.
RAID уже защищает резервные копии?
Он помогает при части аппаратных отказов, но не заменяет исторические версии, отдельную копию и защиту от удаления.
Какой коэффициент дедупликации гарантировать?
Без пилота конкретных данных его нельзя достоверно назначить. Сжатие, шифрование, структура и срока хранения меняют результат.
Почему backup быстрый, а restore медленный?
Профиль чтения и запись на target отличаются от backup. Измерьте конкретный способ восстановления, сеть и целевое storage.
Governance и Compliance одинаково защищают от администратора?
Нет. Режимы имеют разные ограничения действий. Проверьте поддержку, лицензии и процедуру для выбранной платформы.
SMB-папку можно объявить hardened repository?
Нет. Такой режим имеет собственные требования к Linux, блочное хранилище, файловую систему и authentication. Название папки не создаёт защиту.
Нужна ли offline или внешняя копия?
Если требуется пережить общий инцидент площадки или контура доступов, проектируйте независимую копию. Её доступность и восстановление проверяются отдельно.
Сколько места оставить свободным?
Считайте рост, временные операции, GFS и неизменяемые точки. Универсальный процент не заменяет политику хранения и наблюдения.
Сколько раз проверять восстановление?
Проверяйте при приёмке и далее по политике, а также после существенных изменений. Интервал определяется критичностью и скоростью изменений.
Какие данные нужны для коммерческого подбора?
Объём, daily change, срок хранения, версии backup, RPO/RTO, сеть, внешний контур и приёмочный сценарий. Число VM без их размера и профиля недостаточно.