Как выбрать сервер Dell PowerEdge для локальных нейросетей и RAG: сколько GPU и видеопамяти нужно?
Сервер для нейросетей выбирают по модели, длине контекста, одновременным запросам и требуемому времени ответа. Для локальной LLM первым ограничением часто становится видеопамять, а для корпоративного RAG — ещё и поиск, обработка документов, права доступа и хранение. Покупка четырёх GPU не исправит медленный индекс или ошибки в доступе к данным.
Практический порядок такой: проверить качество модели на задачах компании, оценить память весов и KV-cache, измерить сервис под несколькими пользователями и только затем подобрать Dell PowerEdge с поддерживаемыми GPU, питанием и охлаждением. Если заранее известен лишь бюджет, начните с пилота: дорогая платформа не гарантирует полезные ответы.
Руководство посвящено собственному корпоративному сервису внутри инфраструктуры: поиску по документам, помощнику сотрудника, обработке текста и локальному API. Обучение большой модели с нуля и закупка домашнего AI-ПК требуют другого проекта. Расчёты ниже показывают методику; скорость в токенах в секунду определяется тестом конкретного стека.
Что именно покупает компания: LLM, RAG или обучение?
LLM — языковая модель; inference — выполнение готовой модели для генерации ответа. RAG добавляет извлечение подходящих фрагментов из базы знаний и передаёт их в контекст запроса. Эти компоненты могут работать на разных узлах и иметь разные требования к ресурсам.
В RAG есть загрузка файлов, OCR, разбиение на фрагменты, эмбеддинги, индекс, поиск, reranker и генерация. Если PDF плохо распознан или доступ к документам не учитывается, увеличение VRAM не улучшает систему по существу. Сначала уточните формат данных и качество извлечения.
Дообучение отличается от inference. При обучении нужны не только веса, но и градиенты, состояния оптимизатора и активации. Параметроэффективные методы уменьшают часть расходов, однако их нельзя рассчитывать по памяти готового inference. Включите обучение в техническое задание, если планируете выполнять его на той же машине.
| Сценарий | Что измерять | Частое ограничение |
|---|---|---|
| Один чат с LLM | Качество, контекст, время первого токена | VRAM и скорость GPU |
| RAG по документам | Полноту поиска, ACL, задержки этапов | Индекс, CPU, RAM, генерация |
| Многопользовательский API | p95, очередь, ошибки OOM | KV-cache и планирование запросов |
| Дообучение | Размер batch, оптимизатор, checkpoint | Память обучения и связь GPU |
| OCR/эмбеддинги | Скорость загрузки корпуса | CPU/GPU обработки, NVMe |
Прежде чем выбирать GPU, разделите три проекта: генерация ответов готовой моделью, поиск по корпоративным материалам и изменение самой модели обучением. Они используют разные этапы и память. Наличие видеокарты, на которой запускается чат, не подтверждает пригодность той же конфигурации для обучения или большого потока запросов.
Проверка RAG начинается с права доступа к документу. Вопрос сотрудника не должен извлекать закрытые материалы другого подразделения. Системное сообщение модели само по себе не заменяет фильтрацию доступа на уровне поиска. Для пилота нужен набор разрешённых и запрещённых для пользователя документов с заранее известным результатом.
Как рассчитать видеопамять для 8B, 14B, 32B и 70B?
Первичная оценка памяти весов: число параметров × байты на параметр. Для 16-битного представления берут 2 байта, для 8-битного — около 1, для 4-битного — теоретически 0,5. Это только веса: служебные данные квантования, буферы движка и KV-cache добавляются сверху.
Модель 32B в 16-битном представлении требует примерно 64 млрд байт, то есть около 59,6 GiB, ещё до кэша. Поэтому GPU с 48 ГБ не подходит для такого полного размещения весов. Но нельзя автоматически обещать, что карта с 80 ГБ выдержит любую параллельность и длинный контекст.
Отличайте десятичные GB от двоичных GiB: 1 GiB равен 1 073 741 824 байтам. Расчёт в десятичных гигабайтах и показания runtime могут выглядеть различно. Название «70B» тоже не заменяет фактическую архитектуру и число параметров конкретной модели.
Для MoE необходимо хранить поддерживаемое движком представление весов, хотя в отдельном токене активна лишь часть экспертов. Нельзя считать VRAM только по числу активных параметров и игнорировать полный набор экспертов.
| Размер модели | 16 бит | 8 бит | 4 бита |
|---|---|---|---|
| 8 млрд параметров | 16 GB | 8 GB | 4 GB |
| 14 млрд | 28 GB | 14 GB | 7 GB |
| 32 млрд | 64 GB | 32 GB | 16 GB |
| 70 млрд | 140 GB | 70 GB | 35 GB |
Эти величины не являются минимальной VRAM для рабочего сервиса. Они не включают контекст, служебные буферы, масштабы квантования и одновременно выполняющиеся последовательности.
Почему длинный контекст и десять пользователей меняют требования?
При авторегрессионной генерации модель хранит key/value-представления уже обработанных токенов. Этот KV-cache растёт с длиной контекста и числом активных последовательностей. Поэтому короткий одиночный запрос и двадцать длинных диалогов — разные нагрузки, даже если веса модели не меняются.
Для обычной архитектуры attention приблизительная оценка KV на токен: 2 × число слоёв × число KV-heads × размер head × байты элемента. Например, при 32 слоях, 8 KV-heads, размере head 128 и FP16 получается 131 072 байта, или 128 KiB на токен. Контекст 8192 токена занимает около 1 GiB на последовательность; десять таких последовательностей — около 10 GiB до дополнительных расходов. Это учебная архитектура, а не характеристика любой модели 8B.
GQA, MQA, sliding window, MLA и квантованный KV-cache меняют расчёт. Используйте конфигурацию выбранной модели и фактический runtime. Также учитывайте входной контекст вместе с генерируемым ответом и резервом, который выделяет движок.
Число сотрудников не равно числу одновременных генераций. У компании может быть сто пользователей и только пять активных запросов. Измерьте пики, длительность ответов и очередь. Допуск по ожиданию иногда выгоднее покупки ускорителя, который большую часть дня простаивает.
Квантование 4/8 бит: когда экономия памяти оправдана?
Квантование уменьшает размер представления весов, но его результат зависит от метода, модели, оборудования и задач. Проверяйте качество на русскоязычных документах, числах, таблицах, коде и профильной терминологии. Общий benchmark не показывает надёжность ответа по вашим договорам и регламентам.
Не выбирайте precision только по возможности запуска. Сервис, который помещается в VRAM, но путает единицы измерения и ссылки на документы, не проходит приёмку. Создайте набор вопросов с эталонными ответами и критичными ошибками; сравните варианты одной модели при одинаковом RAG-пайплайне.
Поддержка формата должна совпадать у модели, inference engine и GPU. Некоторые операции могут исполняться иначе, чем ожидается, и экономия памяти не обязательно даёт ускорение. Отдельно проверьте, поддерживается ли квантование KV-cache: это другой объект, чем веса.
Зафиксируйте выбранный checkpoint и метод, включая версии библиотек. Формулировка «любая 70B в 4 бит» слишком широкая для коммерческой спецификации. Замена модели после поставки способна изменить и память, и производительность.
Выберите единицы измерения. Производители накопителей и многие маркировки используют десятичные ГБ, тогда как часть инструментов показывает GiB. 64 миллиарда байт — около 59,6 GiB. Разницу нельзя считать внезапно «пропавшей видеопамятью». Также отличайте размер файлов на диске от фактических весов и буферов после загрузки.
Размер ответа входит в бюджет контекста вместе с запросом и найденными фрагментами. Если в настройках допускается 16 тысяч токенов, это не обязательно 16 тысяч токенов входного документа плюс ещё произвольный ответ. Правила длины проверяют по модели и движку. Большая длина без ограничения числа одновременно активных запросов способна занять весь резерв.
Одна большая GPU или несколько небольших: складывается ли VRAM?
Несколько карт не образуют автоматически единый пул памяти. Если модель разделена tensor parallelism, устройства обмениваются результатами вычислений. Если на каждой GPU запускается независимая копия, память каждой должна отдельно вместить модель и контекст. Это разные способы увеличения производительности.
Для модели, которая целиком помещается на одном ускорителе, независимые реплики часто проще масштабировать и обслуживать. Для модели, которая не помещается, нужен поддерживаемый распределённый запуск. Проверьте доступную топологию PCIe/NVLink и поддержку нужного параллелизма.
Четыре GPU по 24 ГБ дают суммарно 96 ГБ физической памяти, но не эквивалентны одной карте 96 ГБ по задержке и сложности запуска. Межсоединение, распределение KV и накладные расходы могут стать ограничением. Не обещайте линейное ускорение по числу карт.
При проектировании нескольких моделей уточните, какие должны работать одновременно. Если каждая GPU закреплена за отдельным сервисом, аварийный сценарий и загрузка будут отличаться от одного большого общего inference.
| Архитектура | Зачем нужна | Что проверить |
|---|---|---|
| Одна GPU | Модель и контекст помещаются целиком | VRAM при реальной параллельности |
| Реплика на каждой GPU | Больше независимых запросов | Балансировку, память одной реплики |
| Tensor parallel | Модель делится между устройствами | Поддержку модели, топологию, обмен |
| Раздельные сервисы | LLM, embeddings, reranker | Изоляцию ресурсов и очереди |
| Offload в RAM | Запуск при ограниченной VRAM | Реальную задержку, PCIe, пропускную способность RAM |
PowerEdge R760xa или обычный R760: что проверить в комплектации?
Dell PowerEdge R760xa — специализированная стоечная платформа для GPU-нагрузок. Обычный PowerEdge R760 имеет другой набор допустимых конфигураций. Выбор начинается с точной модели ускорителя, её мощности и поддерживаемого комплекта, а не с общего слова «GPU» в названии сервера.
Проверьте GPU enablement kit, райзеры, длину и ширину карт, кабели питания, вентиляторы, воздуховоды и тепловые ограничения. Поддержка одного ускорителя не означает разрешение установить любые четыре карты. Для R760xa есть отдельные требования к GPU-комплектам и сочетаниям устройств.
Потребительская видеокарта, которая физически помещается в слот, не становится подтверждённым enterprise-компонентом. В спецификации должны быть поддерживаемые GPU и комплект установки. Предложение без конкретного артикула ускорителя невозможно корректно проверить.
Отдельно проверьте линии PCIe и связь со своими CPU. NIC и накопители используют ту же платформу ввода-вывода; свободный слот не гарантирует нужную ширину интерфейса. Для распределённой модели топология важна особенно сильно.
Квантование — отдельное исполнение модели, а не ползунок бесплатного сжатия. Проверяют поддерживаемый формат, ядра вычислений, точность ответов и совместимость GPU. Сравнивать BF16 и 4-битный вариант можно только при сохранении приемлемого качества на целевых задачах. Для извлечения сумм, дат и реквизитов ошибка ответа важнее красивой скорости генерации.
Сколько CPU, RAM и NVMe нужно для корпоративного RAG?
CPU обслуживает токенизацию, API, обработку файлов и часть поиска. OCR тяжёлых PDF и массовая индексация способны загрузить процессоры независимо от генерации. Выделите ресурсы для обновления базы знаний, чтобы оно не ухудшало интерактивные ответы сотрудников.
RAM нужна сервисам, индексу, обработке документов и загрузке модели. Правило «RAM должна быть вдвое больше VRAM» не универсально. Сложите рабочие наборы компонентов и измерьте максимумы при холодном запуске, переиндексации и восстановлении.
Для исходных документов, весов, индекса и журналов задайте отдельные объёмы. Несжатые векторные значения для миллиона фрагментов по 1024 float32 занимают около 4,096 млрд байт до индекса, метаданных и реплик. Это пример оценки данных, а не окончательный размер выбранной векторной базы.
NVMe ускоряет загрузку и работу с индексом, когда задача действительно упирается в диски. Он не заменяет видеопамять и не превращает постоянный offload в эквивалент полного размещения на GPU. Проверьте ресурс записи при частых обновлениях корпуса.
Как измерить скорость: токены в секунду, TTFT или ответы пользователей?
TTFT — время до первого токена. Оно включает ожидание очереди, подготовку запроса и обработку входного контекста. Скорость генерации после первого токена описывает другой этап. Пользователь может ждать долго, хотя затем ответ появляется быстро.
Измеряйте отдельно короткие вопросы, длинные документы и многопользовательский поток. Укажите токенизатор, длину входа и выхода, batch, precision и версию engine. «100 токенов/с» без этих условий нельзя использовать как обещание поставки.
Для корпоративного сервиса полезны p50/p95 TTFT, время полного ответа, число успешных запросов в минуту, доля ошибок и длина очереди. Усреднённая суммарная генерация может выглядеть впечатляюще, но скрывать медленный индивидуальный диалог.
Сделайте тест длительнее одного удачного запуска. Повторите холодный старт, несколько пиков, отмену запросов и заполнение контекста. Зафиксируйте температурный режим и энергопотребление под устойчивой нагрузкой. Приёмка должна включать качество ответов вместе с производительностью.
| Метрика | Что показывает | Почему нужна |
|---|---|---|
| TTFT p95 | Ожидание первого токена для медленных запросов | Отзывчивость сервиса |
| Полный ответ p95 | Длительность законченной операции | Реальное время сотрудника |
| Запросы/мин | Пропускную способность | Размер обслуживаемой команды |
| Пиковая VRAM | Запас при контексте и concurrency | Риск OOM |
| Ошибки и очередь | Поведение при перегрузке | Устойчивость |
| Качество/ACL | Правильность и доступность фрагментов | Пригодность корпоративного RAG |
Как рассчитать питание и охлаждение GPU-сервера?
Начните с максимального допустимого состава платформы, затем оцените рабочий режим. Например, четыре устройства с условным лимитом 350 Вт дают 1,4 кВт только по GPU; CPU, память, вентиляторы и диски добавят расход. Это пример сложения мощности, не спецификация R760xa.
Два БП по 2400 Вт в резервной схеме нельзя считать безопасными 4800 Вт после отказа одного. Оставшийся источник и его ввод должны выдерживать согласованную нагрузку. Аналогично проверяются PDU, кабели, UPS и выделенная электрическая линия.
Почти вся потреблённая электроэнергия превращается в тепло. Нагрузка 2 кВт выделяет около 6824 BTU/ч по коэффициенту 3,412. Оцените температуру входящего воздуха, воздушный поток, плотность стойки и режим при отказе вентилятора.
Пассивная серверная GPU нуждается в правильном принудительном обдуве шасси. Не оценивайте охлаждение по отсутствию собственного вентилятора карты. Плотная платформа также требует проверки шума и места размещения: обычный офис редко подходит для длительной GPU-нагрузки.
Что важно для безопасности и доступа к корпоративным документам?
Локальное размещение даёт контроль над инфраструктурой, но само по себе не обеспечивает конфиденциальность. Проверьте сетевые доступы, учётные записи, журналы, резервные копии, обновления и удалённые зависимости. Модель или библиотека может обращаться к внешнему сервису, если это предусмотрено приложением.
RAG должен учитывать права пользователя при извлечении фрагментов. Если сотрудник не имеет доступа к финансовому документу, он не должен получать его содержание через чат. Фильтрация лишь готового ответа слабее корректного контроля на уровне поиска и данных.
Отдельно проектируйте ограничения контекста, длины ответа и параллельности. Они защищают от исчерпания GPU одним тяжёлым запросом и делают требования к железу предсказуемыми. Для новых моделей и обновлений индекса нужен контролируемый процесс, а не замена production-компонента без теста.
Проверяйте recovery: можно ли восстановить исходные файлы, индекс, конфигурацию, модель и ключи, которые необходимы сервису. Наличие файла весов на NVMe ещё не означает готовность всей системы после аварии.
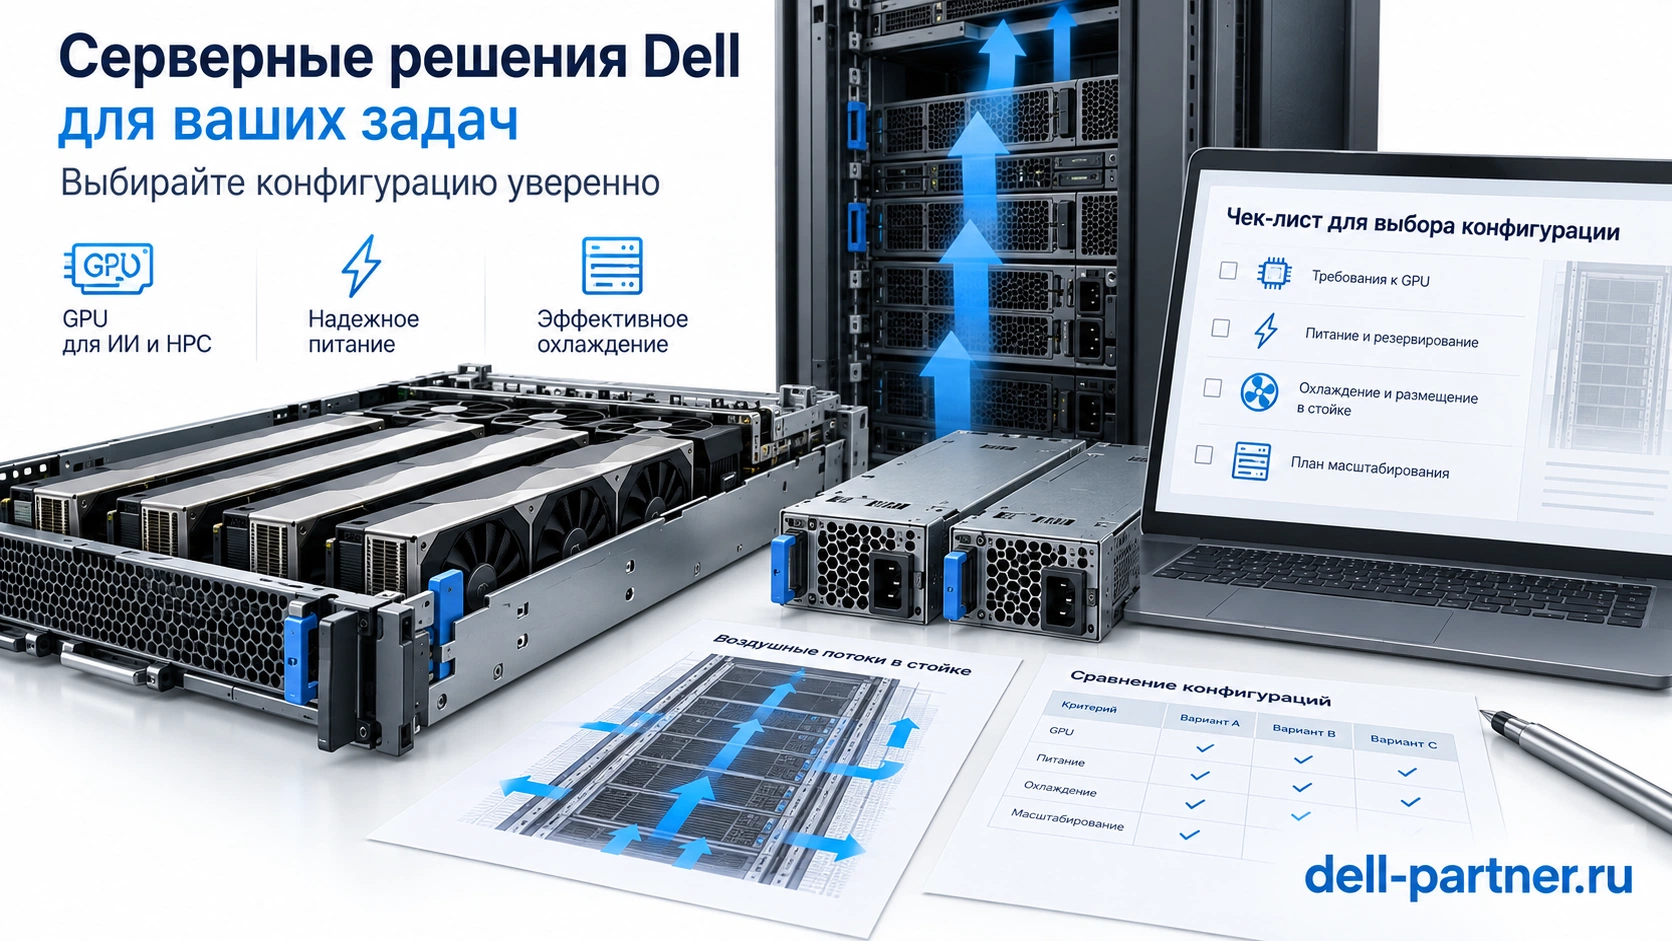
Как выглядит пилот до закупки и техническое задание?
Выберите несколько реальных сценариев: вопрос по регламенту, поиск условия договора, извлечение данных из таблицы, длинный запрос, массовый запуск сотрудников. Подготовьте обезличенный корпус и набор ожидаемых ответов. Ошибки разбирайте отдельно: источник не найден, найден неверно, ответ исказил факт, нарушены права.
Запустите пилот на выбранной модели и precision. Увеличивайте concurrency до появления неприемлемой очереди или ошибок, сохраняя измерения. После этого посчитайте требуемое число реплик и аварийный запас. Не превращайте один удачный demo в подтверждение работы ста сотрудников.
В ТЗ укажите checkpoint, engine, контекст, длину ответа, одновременные запросы, TTFT/latency, качество и ACL. Аппаратная часть должна перечислять GPU, VRAM, CPU, RAM, NVMe, сеть и комплект питания/охлаждения. Все изменяемые допущения лучше вынести в согласованный перечень.
При сравнении предложений используйте один и тот же профиль теста. Иначе более дешёвый вариант с коротким контекстом и крупный сервер с длинными запросами окажутся в несопоставимых условиях.
Как оценить KV-cache: пример, в котором контекст меняет класс сервера
Для обычной модели с attention кеш хранит ключи и значения по слоям. Учебная оценка одного токена: 2 × число слоёв × число KV-голов × размер головы × байты элемента. Она помогает увидеть масштаб, но не заменяет расчёт конкретной архитектуры: группировка голов, гибридные слои, служебные блоки, квантование кеша и особенности движка меняют результат.
Пусть условная модель имеет 32 слоя, восемь KV-голов, размер головы 128 и двухбайтные элементы кеша. На один токен получается 2 × 32 × 8 × 128 × 2 = 131 072 байта, то есть 128 KiB. Для последовательности в 8192 токена это 1 GiB. Шестнадцать таких одновременно активных последовательностей потребуют около 16 GiB только по этой упрощённой оценке кеша.
Если при той же архитектуре увеличить длину до 32 768 токенов, одна последовательность занимает около 4 GiB, а шестнадцать — 64 GiB. Это не характеристика любой модели 32B и не готовый заказ GPU. Пример показывает, почему загрузившиеся веса ещё не доказывают вместимость корпоративного сервиса.
В движке также резервируются память вычислений, графы, временные буферы и рабочие пространства. Кеш может выделяться блоками; заполнение не всегда совпадает с числом токенов пользовательского текста. Размер входа в символах или страницах PDF нельзя напрямую использовать как число токенов. Для пилота нужно прогнать документы тем же токенизатором, который использует сервис.
Нормальный порядок подбора: зафиксировать модель и формат; измерить память загрузки; задать вход, ответ и одновременность; проверить рабочее заполнение кеша; добавить операционный резерв; повторить длительный поток. Повышение разрешённой доли занятой памяти до предела не является универсальным способом сделать слишком маленькую GPU подходящей.
| Контекст активной последовательности | Кеш одной последовательности | Кеш 16 последовательностей |
|---|---|---|
| 8192 токена | Около 1 GiB | Около 16 GiB |
| 16384 токена | Около 2 GiB | Около 32 GiB |
| 32768 токенов | Около 4 GiB | Около 64 GiB |
| Условия всех строк | 32 слоя,8KV-голов,128 элементов,2 байта | Веса и буферы не включены |
Почему число сотрудников нельзя переводить в GPU одним коэффициентом?
У компании может быть 300 сотрудников, но одновременно генерироваться только несколько ответов. Или у отдела из 20 человек десятки запросов создаёт автоматическая обработка файлов. Для оборудования важны активные последовательности, их длины, поток поступления и допустимая очередь. Число учётных записей является бизнес-данными, а не прямым вычислительным нормативом.
Запишите три профиля: короткий поиск факта, ответ по нескольким документам и длинная обработка текста. Для каждого нужны входные токены, выходные токены, частота и время ожидания. Затем оцените, какие профили могут совпасть. Если большой документ занимает движок в момент общего утреннего пика, короткие ответы могут замедлиться даже при невысокой средней нагрузке за день.
Разделяют время до первого токена и скорость последующего вывода. Первое связано с подготовкой, очередью и обработкой входа; второе — с генерацией ответа. Пользователь может увидеть быстрый первый символ и ждать длинный текст несколько минут. Или получать быстрый полный ответ после долгого ожидания в очереди. Одна средняя метрика не объясняет оба сценария.
Учебный расчёт: если поступают два запроса в секунду, а среднее время нахождения запроса в сервисе составляет десять секунд, среднее число незавершённых запросов около 20 при устойчивом режиме. Это ориентир закона Литтла, а не обещание, что GPU должна одновременно вычислять 20 последовательностей. Часть запросов может ждать, а пиковые режимы требуют отдельной проверки. При поступлении быстрее обслуживания очередь растёт, и среднее становится непригодным для стабильной оценки.
Определите правила ограничения нагрузки: максимальную длину, размер ответа, приоритет сервисных задач и поведение при заполнении очереди. Возвращаемая понятная ошибка или ограничение может быть лучше бесконечного ожидания. Решение об этих правилах принимает владелец сервиса, а оборудование выбирают под согласованный уровень обслуживания.
Одна большая GPU, несколько GPU или несколько экземпляров модели?
Увеличить суммарную видеопамять и увеличить пропускную способность — разные задачи. Если модель не помещается на одной GPU, рассматривают поддерживаемое разделение её вычислений и памяти между устройствами. При этом появляются обмены и требования к топологии. Две карты с большой суммой VRAM не гарантируют нужную скорость одного ответа.
Если модель помещается на одной GPU, иногда рациональны независимые экземпляры с распределением запросов. Это увеличивает число одновременно обслуживаемых задач, но каждый экземпляр хранит собственные веса и использует свой кеш. Такая схема не помогает одному запросу, которому требуется больше памяти, чем доступно на одной карте.
При выборе нескольких ускорителей проверяют доступные линии PCIe, расположение относительно CPU, поддерживаемые способы обмена, питание и охлаждение. GPU-комплект сервера включает не только карту: нужны совместимые райзеры, кабели, блоки питания, термопрофиль и прошивки. У R760xa одинаковое имя платформы не означает одинаковый допустимый набор карт в каждой поставке.
Деление модели между несколькими серверами добавляет сетевую зависимость. Обычная офисная сеть не становится подходящей только по числу гигабит на порту. Для распределённого расчёта важны задержка, обмены выбранного движка и стабильность под нагрузкой. Переход к такой архитектуре должен объясняться задачей, которую нельзя разумно решить более простым комплектом.
В пилоте сравнивайте минимум два режима: одна последовательность и рабочая параллельность. Полезно отдельно проверить длинные входы, смешанный поток и доступ после отказа экземпляра. Выберите схему, которая обеспечивает целевые ответы и понятный ремонт. Самый большой набор GPU может оказаться менее удобным, если его распределённый стек сложно обновлять и восстанавливать.
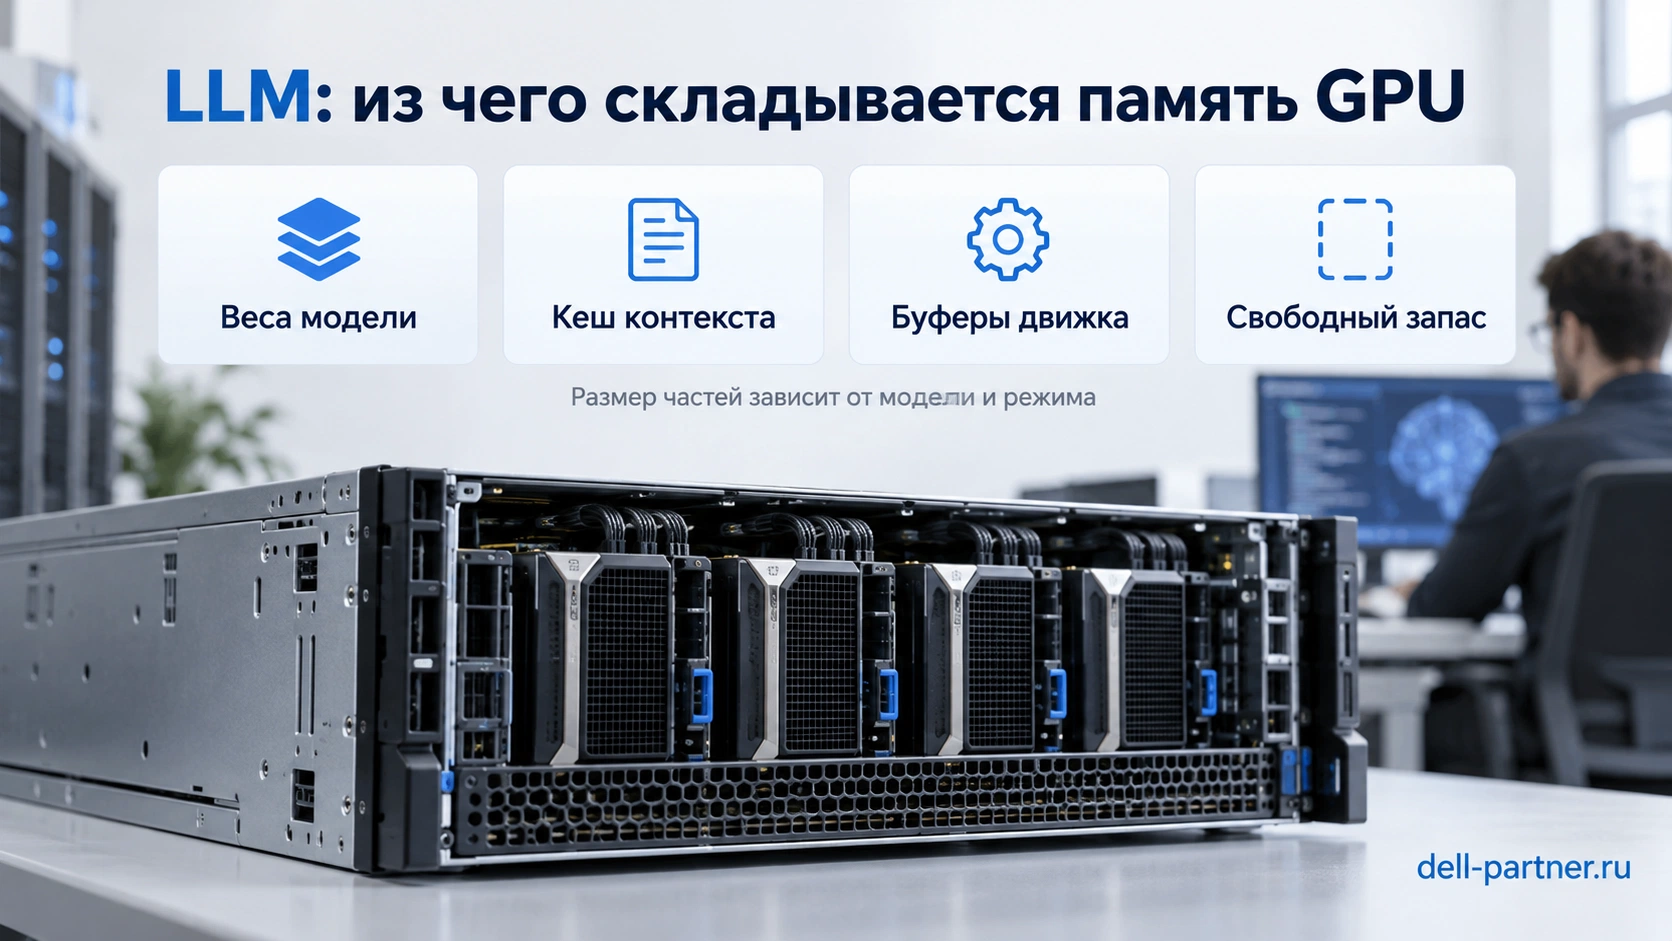
RAG: какие ресурсы нужны кроме сервера генерации?
Корпоративный поиск состоит из загрузки, распознавания, разбиения, создания векторов, индексации, поиска и формирования контекста. Эти этапы могут выполняться на разных устройствах и по разному расписанию. Для каталога текстовых документов и массива сканов профиль будет различаться даже при одинаковом числе файлов.
При первом заполнении индекса важна пакетная скорость. При ежедневной эксплуатации — поступление новых материалов, обновление прав и задержка запроса. Нельзя выбирать весь сервер только по скорости первоначальной индексации, если после неё основной расход создаёт генерация. И наоборот, быстрые ответы не помогут сервису, который не успевает обработать новые документы.
Пример для оценки векторного массива: один миллион векторов по 1024 компонента в FP32 содержит 1 000 000 × 1024 × 4 байта, то есть 4,096 ГБ чистых значений. Реальный индекс дополнительно хранит структуры поиска, идентификаторы, метаданные и иногда текст. Формат и тип индекса меняют бюджет, поэтому размер значений не следует объявлять полным объёмом базы.
Разграничение доступа нужно проверять после обновления роли и удаления документа. Старый индекс или кеш не должен продолжать отдавать закрытый фрагмент. Также задают правила обработки некорректных файлов, повторного загрузочного задания и восстановления индекса. Локальность размещения помогает управлять данными, но не заменяет организационные и программные меры доступа.
В спецификации отдельно показывают CPU/RAM для поиска, хранилище текстов и индекса, GPU генерации и ресурсы распознавания. Для небольшой нагрузки часть ролей может быть объединена. При росте полезно понимать, какую часть можно выделить без полной замены сервера. Такой проект оставляет путь развития и позволяет искать ограничение по этапу, а не менять весь комплект вслепую.
Как провести пилот локальной нейросети и оформить результат?
Подготовьте контрольный набор вопросов с ожидаемыми фактами: обычные, неоднозначные, требующие нескольких документов и не имеющие ответа в базе. Отдельно включите запретные документы и провокационные запросы на раскрытие доступа. Это проверяет полезность сервиса; демонстрационный диалог с любым красивым ответом её не подтверждает.
Зафиксируйте модель, файл весов, квантование, движок, GPU, драйвер, входные параметры и температуру генерации. После изменения версии повторяют хотя бы контрольный набор и рабочую нагрузку. Иначе результат относится к предыдущему программному комплекту. Не следует обновлять все компоненты одновременно перед выдачей нового сервера без возможности определить причину изменения.
Тест нагрузки должен воспроизводить реальное поступление запросов, а не только непрерывную генерацию одинаковых коротких ответов. Измеряют очередь, время первого токена, длительность ответа, заполнение VRAM, ошибки и долю неуспешных запросов. Для RAG сохраняют этапы поиска и генерации отдельно. Это помогает отличить маленькую GPU от медленного индекса или неправильного ограничения длины.
Прогоняют режим после прогрева, перезапуск сервиса и возврат после отказа. Важно знать время загрузки модели и готовности к работе. Несколько независимых экземпляров помогают только при правильно настроенном переключении запросов. Автоматический перезапуск контейнера не гарантирует мгновенную доступность большой модели.
Итог пилота — не одна цифра токенов в секунду, а допустимые профили задач, качество, параллельность и условия расширения. Для закупки указывают, что именно прошло проверку, какие данные использованы и какие ограничения остаются. Это позволяет сравнить предложения Dell по одинаковому рабочему результату и избежать обещаний скорости, не связанных с вашим сервисом.
Как сравнить короткий чат, длинные документы и пакетную обработку на одном сервере?
Эти три режима имеют разные требования. Короткий чат чувствителен к очереди и времени первого ответа. Длинный документ увеличивает обработку входа и память контекста. Пакетная обработка может ставить пропускную способность выше немедленной реакции, если результат нужен позднее. Нельзя назначить один профиль по всем задачам только потому, что используется одна модель.
Для короткого чата сохраните распределение длины входа и ответа, частоту и допустимое ожидание. Для документов добавьте токенизацию, отбор фрагментов и максимальную поддерживаемую длину. Для пакета — размер очереди, срок завершения, повтор неуспешных заданий и доступное окно. Общие 100 сотрудников не заменяют ни одной из этих величин.
Если пакет запускается днём вместе с сотрудниками, он может занять GPU и ухудшить интерактивный сервис. Рассмотрите расписание, разделение экземпляров или приоритеты. Эти варианты способны быть рациональнее максимального увеличения GPU, если бизнес допускает отложенную обработку. Но изменение сроков должно быть согласовано, а не скрыто в настройках.
Пилот выполняют на смешанном потоке. Последовательно проверить три режима по отдельности полезно для диагностики, но это не подтверждает их совместную работу. Измерьте качество и очереди во время совпадения. Особенно важны длинные задания, которые продолжаются, когда начинается новый пик.
В коммерческом задании укажите, какой режим обязателен, какой допускает ожидание и какой можно вынести в другое окно. Это связывает стоимость сервера с сервисом. Заказчик получает контролируемую конфигурацию, а поставщик не должен угадывать, что подразумевается под «нейросетью для компании».
Квантование, кеш и offload: почему нельзя заказывать GPU по размеру файла?
Размер скачанных весов является начальным ориентиром, но не полным расходом во время исполнения. Движок может хранить дополнительную информацию, рабочие пространства и кеш. Разные форматы используют разные ядра и поддержку устройств. Поэтому файл на 16 ГБ не обещает запуск сервиса с 16 ГБ VRAM.
Квантование весов и квантование KV-cache относятся к разным частям бюджета. Уменьшение одного не обязательно уменьшает другое. При оценке сравнивают качество на целевых вопросах, поддерживаемый стек и режим нагрузки. На техническом извлечении фактов потеря точности может перечеркнуть экономию оборудования.
Перенос части данных в системную память или на другой ресурс изменяет путь обмена. Если выбранный движок его поддерживает, это ещё не гарантирует приемлемую задержку. Проверяют пропускную способность, размер переноса и характер обращений. Назначить много RAM вместо нужной VRAM и обещать прежнюю скорость неточно.
Повторное использование общего префикса или других поддерживаемых кешей зависит от совпадения данных и режима. Корпоративные запросы не всегда имеют один и тот же префикс, а персональные права могут менять контекст. Не используйте лучший прогон с уже готовым кешем как единственную оценку первого обращения.
Для версии с новым форматом проведите контроль точности и нагрузку заново. Сохраните исходные параметры и условия возврата. В сравнении оборудования нужно понимать, сколько результата дал новый GPU, сколько — изменённый формат, а сколько — другая длина входа. Это разные способы оптимизации, и их нельзя объединять в одну аппаратную гарантию.
Как заложить расширение сервиса и обновление модели без полной замены проекта?
Предусмотрите не максимальную гипотетическую модель, а известные следующие задачи. Например, увеличение числа одновременных запросов, более длинные документы или второй профиль генерации. Для каждой запишите, какая часть ресурса растёт: веса, кеш, поиск, хранилище или поток обработки. Такой план информативнее общего запаса «на любые нейросети».
Если нужно увеличить параллельность при модели, помещающейся на одном ускорителе, может подойти дополнительный экземпляр. Если растёт сама модель, понадобится иной бюджет памяти и поддерживаемое распределение. Если задержка возникает в поиске, добавление GPU генерации может оказаться не первоочередным шагом. Ресурс выбирают по этапу.
В платформе проверяют будущие GPU-комплекты, число слотов, линии, питание и охлаждение. Сравните добавление карты, замену одной более ёмкой и отдельный узел. Полный бюджет должен включать программный стек и работу распределения. Пустой слот без подходящего райзера или термопрофиля не является готовой возможностью роста.
Для обновления модели сохраните контрольный набор и историю результатов. Новая версия может изменить качество, расход памяти и токенизацию; одинаковое имя семейства не гарантирует прежний режим. Приёмка обновления включает все обязательные рабочие профили и запрещённые сценарии доступа.
Эксплуатационный запас нужен также для перезапуска, загрузки и обслуживания. Если весь бюджет используется только при одновременно работающих экземплярах, проект должен иметь понятный режим во время обновления одного из них. Полезная отказоустойчивость зависит от маршрутизации и доступного результата, а не только от наличия второй карты.
Как выбрать и купить сервер Dell для локальной LLM и RAG?
Подготовьте модель, обезличенный набор вопросов, размер корпуса, требования к доступам и измеренный профиль запросов. Если модель ещё не выбрана, сначала проведите проверку качества. Покупка инфраструктуры до этого решения оставляет главный риск проекта открытым.
В каталоге GPU-серверов Dell сравнивайте поддерживаемый состав платформ, а не только максимальное число ускорителей. Для проекта с четырьмя GPU, длинным контекстом и несколькими сервисами важны не только карты, но и CPU/RAM, топология, NVMe, отказоустойчивость и размещение.
Запрос на подбор формулируйте через задачу: какой сервис должен работать, с какой задержкой, качеством и числом одновременных обращений. Тогда коммерческая конфигурация будет привязана к проверяемому результату, а план расширения — к понятным ограничениям пилота.
Частые вопросы
Сколько VRAM нужно для модели 70B?
Только веса в 16-битном представлении занимают около 140 GB, в 4-битном — теоретически 35 GB до накладных расходов. Рабочая VRAM дополнительно зависит от KV-cache, context и concurrency. Точный минимум проверяют на выбранном checkpoint.
Можно ли запускать LLM без GPU?
Да, некоторые стеки поддерживают CPU inference. Полезность такого режима определяется временем ответа, RAM и пропускной способностью памяти. Запуск модели не означает достаточную скорость для корпоративного сервиса.
RAG обязательно требует большой модели?
Нет. Проверяйте качество поиска и ответы на собственных документах. Хорошо организованный корпус и подходящая небольшая модель могут быть полезнее более крупной модели с плохим извлечением.
Две карты по 48 ГБ заменяют одну 96 ГБ?
Не автоматически. Нужны поддерживаемое разделение модели и обмен между GPU. Сравнивайте память, топологию и задержки на целевой нагрузке.
Почему сервис падает при нескольких пользователях?
Возможны исчерпание KV-cache, слишком длинные контексты, недостаточные ограничения очереди или нехватка памяти вспомогательным службам. Снимите метрики по этапам, а не только загрузку GPU.
Нужны ли NVLink и NVSwitch для любого RAG?
Нет. Их значение растёт при постоянном обмене между ускорителями. Для независимых реплик небольших моделей может быть достаточно поддерживаемой PCIe-архитектуры.
Можно ли поставить любую RTX в PowerEdge?
Нет. Проверьте матрицу поддерживаемых ускорителей и весь GPU-комплект. Физический слот не подтверждает питание, охлаждение и поддержку устройства.
Можно ли одновременно индексировать документы и обслуживать чат?
Да, если ресурсы разделены и это проверено. OCR, embeddings и построение индекса могут ухудшать ответы. Включите одновременную работу в нагрузочный сценарий.
Квантование всегда ускоряет модель?
Нет. Эффект зависит от оборудования, kernel и формата. Проверяйте и память, и задержку, и качество; экономия VRAM сама по себе не доказывает ускорение.
Какая скорость в токенах/с нужна сотрудникам?
Зависит от длины ответов и допустимого ожидания. Задайте время первого токена и полного ответа, затем измерьте нужную параллельность. Универсальной нормы для всех задач нет.
Локальный AI означает отсутствие внешнего трафика?
Нет. Проверьте приложение, библиотеки, авторизацию и интеграции. Само размещение GPU в вашей стойке не исключает внешних обращений программного стека.
Что передать поставщику для подбора?
Checkpoint, precision, engine, контекст, длину ответа, concurrency, размер корпуса и критерии приёмки. Дополнительно — питание, охлаждение, сеть и требования к резервированию.